Robots.txt: Файл, який пошукові системи читають першим | SEO Хитрощі
Перш ніж пошукова система почне досліджувати ваш сайт, біля дверей на неї вже чекає невеликий текстовий файл.
Короткий огляд
Robots.txt — це простий текстовий файл, який повідомляє пошуковим роботам, які частини сайту їм дозволено або заборонено сканувати. Передусім це директива для керування скануванням, а не команда для індексації чи ранжування.
Коректний
robots.txtмає бути доступним у корені сайту та повертати інструкції, призначені для пошукових роботів. Під час реальної SEO-перевірки недостатньо переконатися, що файл існує: потрібно також перевірити його вміст і спосіб, у який цей файл створюється.
Питання
Файл robots.txt здається надто простим, щоб мати велике значення.
Один невеликий текстовий файл за знайомою адресою:
https://example.com/robots.txt
Але що саме він має робити?
Чи повідомляє він пошуковим системам, які сторінки потрібно індексувати?
Чи впливає на позиції в результатах пошуку?
Чи просто дає пошуковим роботам інструкції перед тим, як вони почнуть досліджувати сайт?
І, мабуть, найважливіше:
Що ми взагалі маємо побачити, коли відкриваємо robots.txt сайту?
Саме це питання стало відправною точкою цієї SEO-перевірки.
Чому це важливо
Пошуковим системам потрібно ефективно сканувати сайти. Файл robots.txt надає стандартне місце в корені сайту, де можна розмістити інструкції для пошукових роботів.
Але кілька SEO-понять легко переплутати.
Сканування — це не те саме, що індексація.
Індексація — це не те саме, що ранжування.
Файл robots.txt передусім стосується сканування: він повідомляє роботам, до яких частин сайту їм дозволено доступ, а яких слід уникати.
Тому цей файл є частиною технічної SEO-інфраструктури сайту. Якщо він відсутній, недоступний, некоректно сформований або містить ненавмисні інструкції, пошукові роботи можуть не отримати вказівки, які власник сайту хотів їм надати.
І тут є ще один важливий урок:
Знайти файл robots.txt — ще не означає завершити перевірку.
Потрібно також подивитися, що саме містить файл — а для сайту, який генерується автоматично, зрозуміти, як цей вміст взагалі потрапив до нього.
Перевірка
Ми почали з найпростішої перевірки:
Чи має сайт файл robots.txt взагалі?
Жива URL-адреса одразу дала відповідь:
https://pivtorak.studio/robots.txt → 404 File not found
Тож перш ніж перевіряти директиви, правила сканування чи сумісність із sitemap, нам потрібно було з’ясувати, чому файл відсутній.
Далі ми простежили, як побудований сайт і яким чином Hugo може генерувати robots.txt.
Спочатку ми перевірили конфігурацію Hugo на наявність параметра, який відповідає за генерацію цього файлу:
enableRobotsTXT = trueПотім ми шукали явний шаблон robots.txt у проєкті та в темі:
layouts/robots.txt
themes/hugo-book/layouts/robots.txt
Також перевірили, чи не існує вже статичного файлу:
static/robots.txtУ жодному з цих місць вихідного файлу robots.txt не було.
Далі ми перевірили текстові шаблони теми Hugo та доступні формати виводу, щоб зрозуміти, що саме Hugo може використати під час генерації robots.txt як текстового файлу.
Нарешті, замість того щоб одразу розгортати неперевірену зміну, ми виконали локальну збірку Hugo та перевірили згенерований результат:
E:\GitHubProjects\pivtorak.studio.github.io\public\robots.txtЦе дало нам контрольований спосіб відповісти на наступне питання:
Чи може Hugo правильно згенерувати відсутній файл, перш ніж ми змінимо живий сайт?
Перевірка
Саме тут наше дослідження змінило напрямок.
Локальна збірка підтвердила, що Hugo може згенерувати файл robots.txt — але згенерований файл не був коректним robots.txt для нашого сайту.
Тому ми зупинилися, перш ніж робити commit або деплой.
Source → Build
У вихідній конфігурації було:
enableRobotsTXT = trueПісля збірки Hugo створив:
E:\GitHubProjects\pivtorak.studio.github.io\public\robots.txtТож на перший погляд могло здатися, що проблему вирішено.
Але коли ми відкрили згенерований файл, побачили зовсім не те, що очікували.
Замість невеликого текстового файлу на кшталт:
User-agent: *
Allow: /

Sitemap: https://pivtorak.studio/sitemap.xml
згенерований файл мав приблизно 34 KB і починався так:
Pivtorak.Studio
- ...
Далі він продовжувався довгим списком сторінок і URL-адрес сайту.
Цей вміст явно не був набором інструкцій для пошукових роботів.
Фактично файл являв собою текстове представлення вмісту сайту, а не робочий robots.txt.
Чому це було проблемою
Файл robots.txt має передавати правила сканування за допомогою таких директив, як User-agent, Allow, Disallow та, за потреби, посилання Sitemap.
Наш згенерований файл цього не робив.
Тому, хоча:
файл існував,
ми не могли зробити висновок, що:
robots.txt працює.
Ця різниця була критично важливою.
Build успішно створив файл за очікуваним шляхом, але вміст цього файлу був неправильним.
Тому результат перевірки на цьому етапі був таким:
Source
   ↓
enableRobotsTXT = true
   ↓
Build
   ↓
robots.txt exists
   ↓
Content is incorrect
   ↓
STOP
Ми ще не дійшли до етапу Live, і не було жодних підстав робити commit або деплой неперевіреного результату.
Наступним кроком було не розгортання.
Потрібно було з’ясувати, чому Hugo згенерував саме такий вміст і який шаблон його сформував.
Підсумок
Перевірка robots.txt має починатися з простого питання:
Чи існує файл і чи містить він ті інструкції, які має містити?
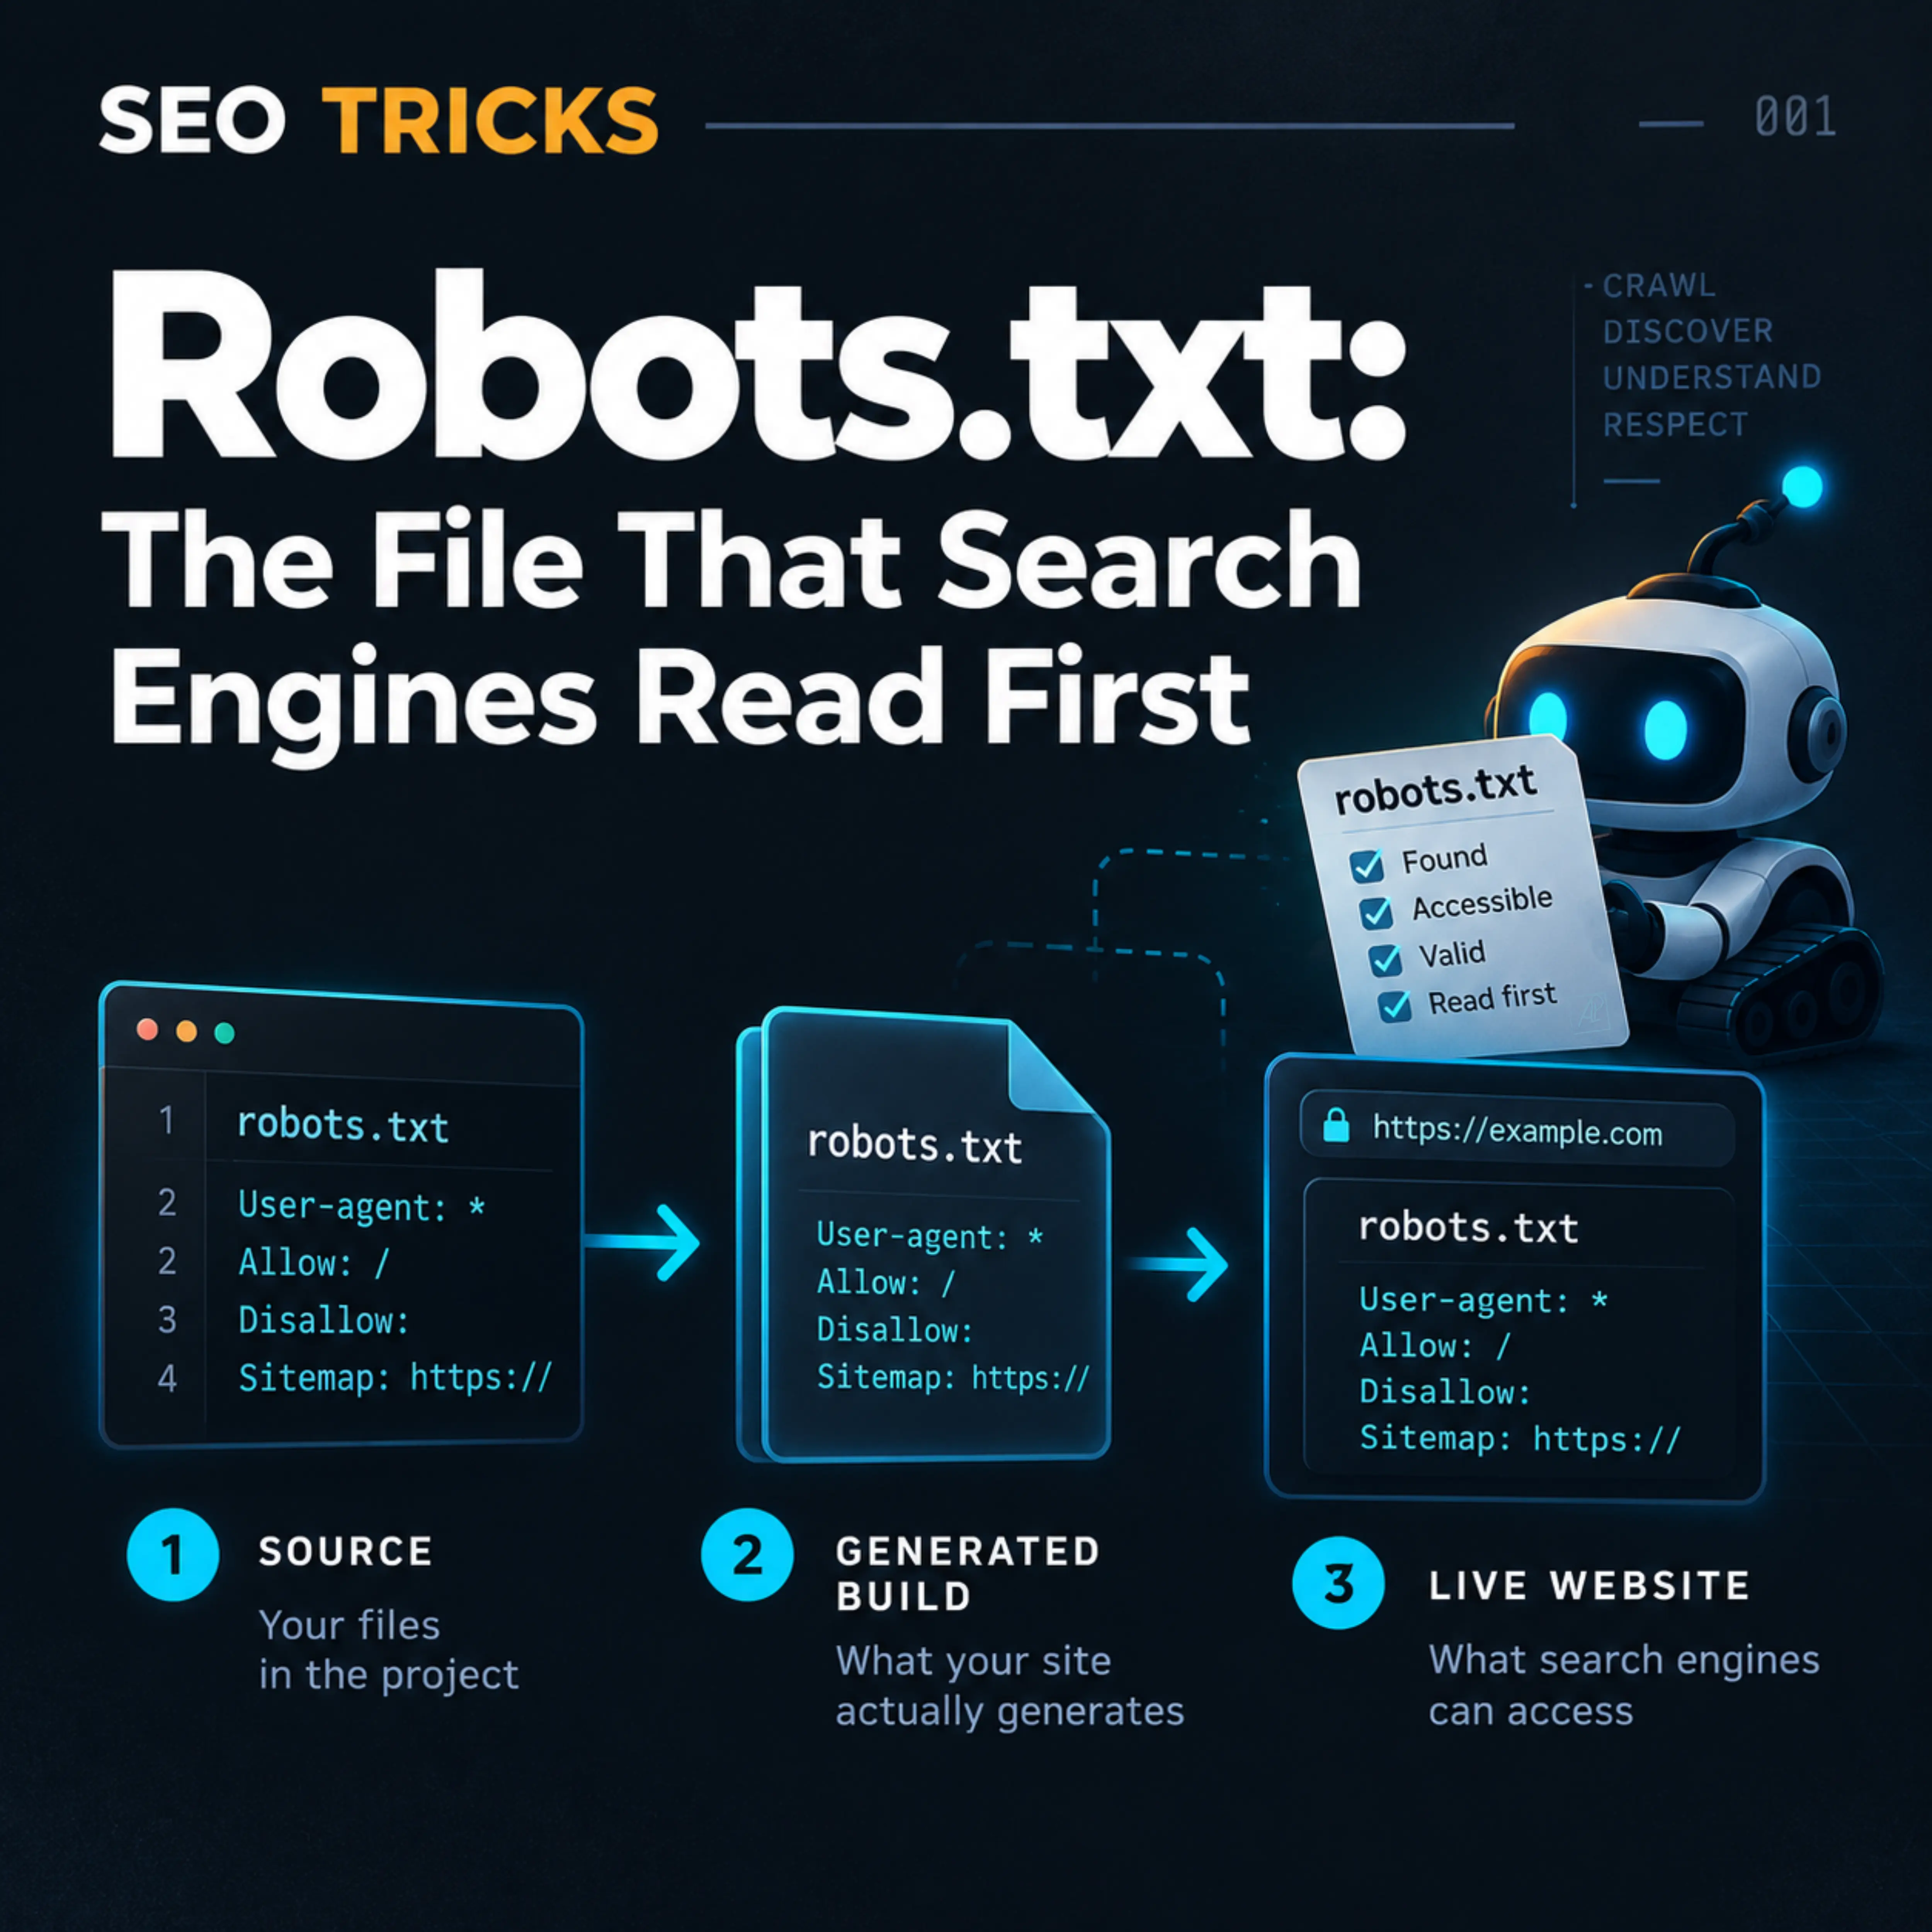
Для сайту, який генерується автоматично, найбезпечніше перевіряти його на трьох рівнях:
Source → Generated Build → Live
Вихідний код показує, що саме ми попросили систему зробити.
Збірка показує, що система насправді згенерувала.
Живий сайт показує, що саме пошукові роботи реально можуть отримати.
Самого факту, що файл з’явився під час збірки, недостатньо. І того, що файл існує за очікуваною URL-адресою, теж недостатньо.
Перевірте файл. Потім перевірте, що знаходиться всередині нього.
Іноді найменший SEO-файл заслуговує на перевірку на трьох рівнях.
robots.txt · технічне SEO · сканування · краулінговий бюджет · sitemap
Alt-text:
Діаграма трирівневої перевірки robots.txt, що показує перевірки Source, Generated Build та Live website.
SEO Хитрощі. Robots.txt: Файл, який пошукові системи читають першим. AP | Pivtorak.Studio. 07.09.2026
© Анна Півторак (Костюк)