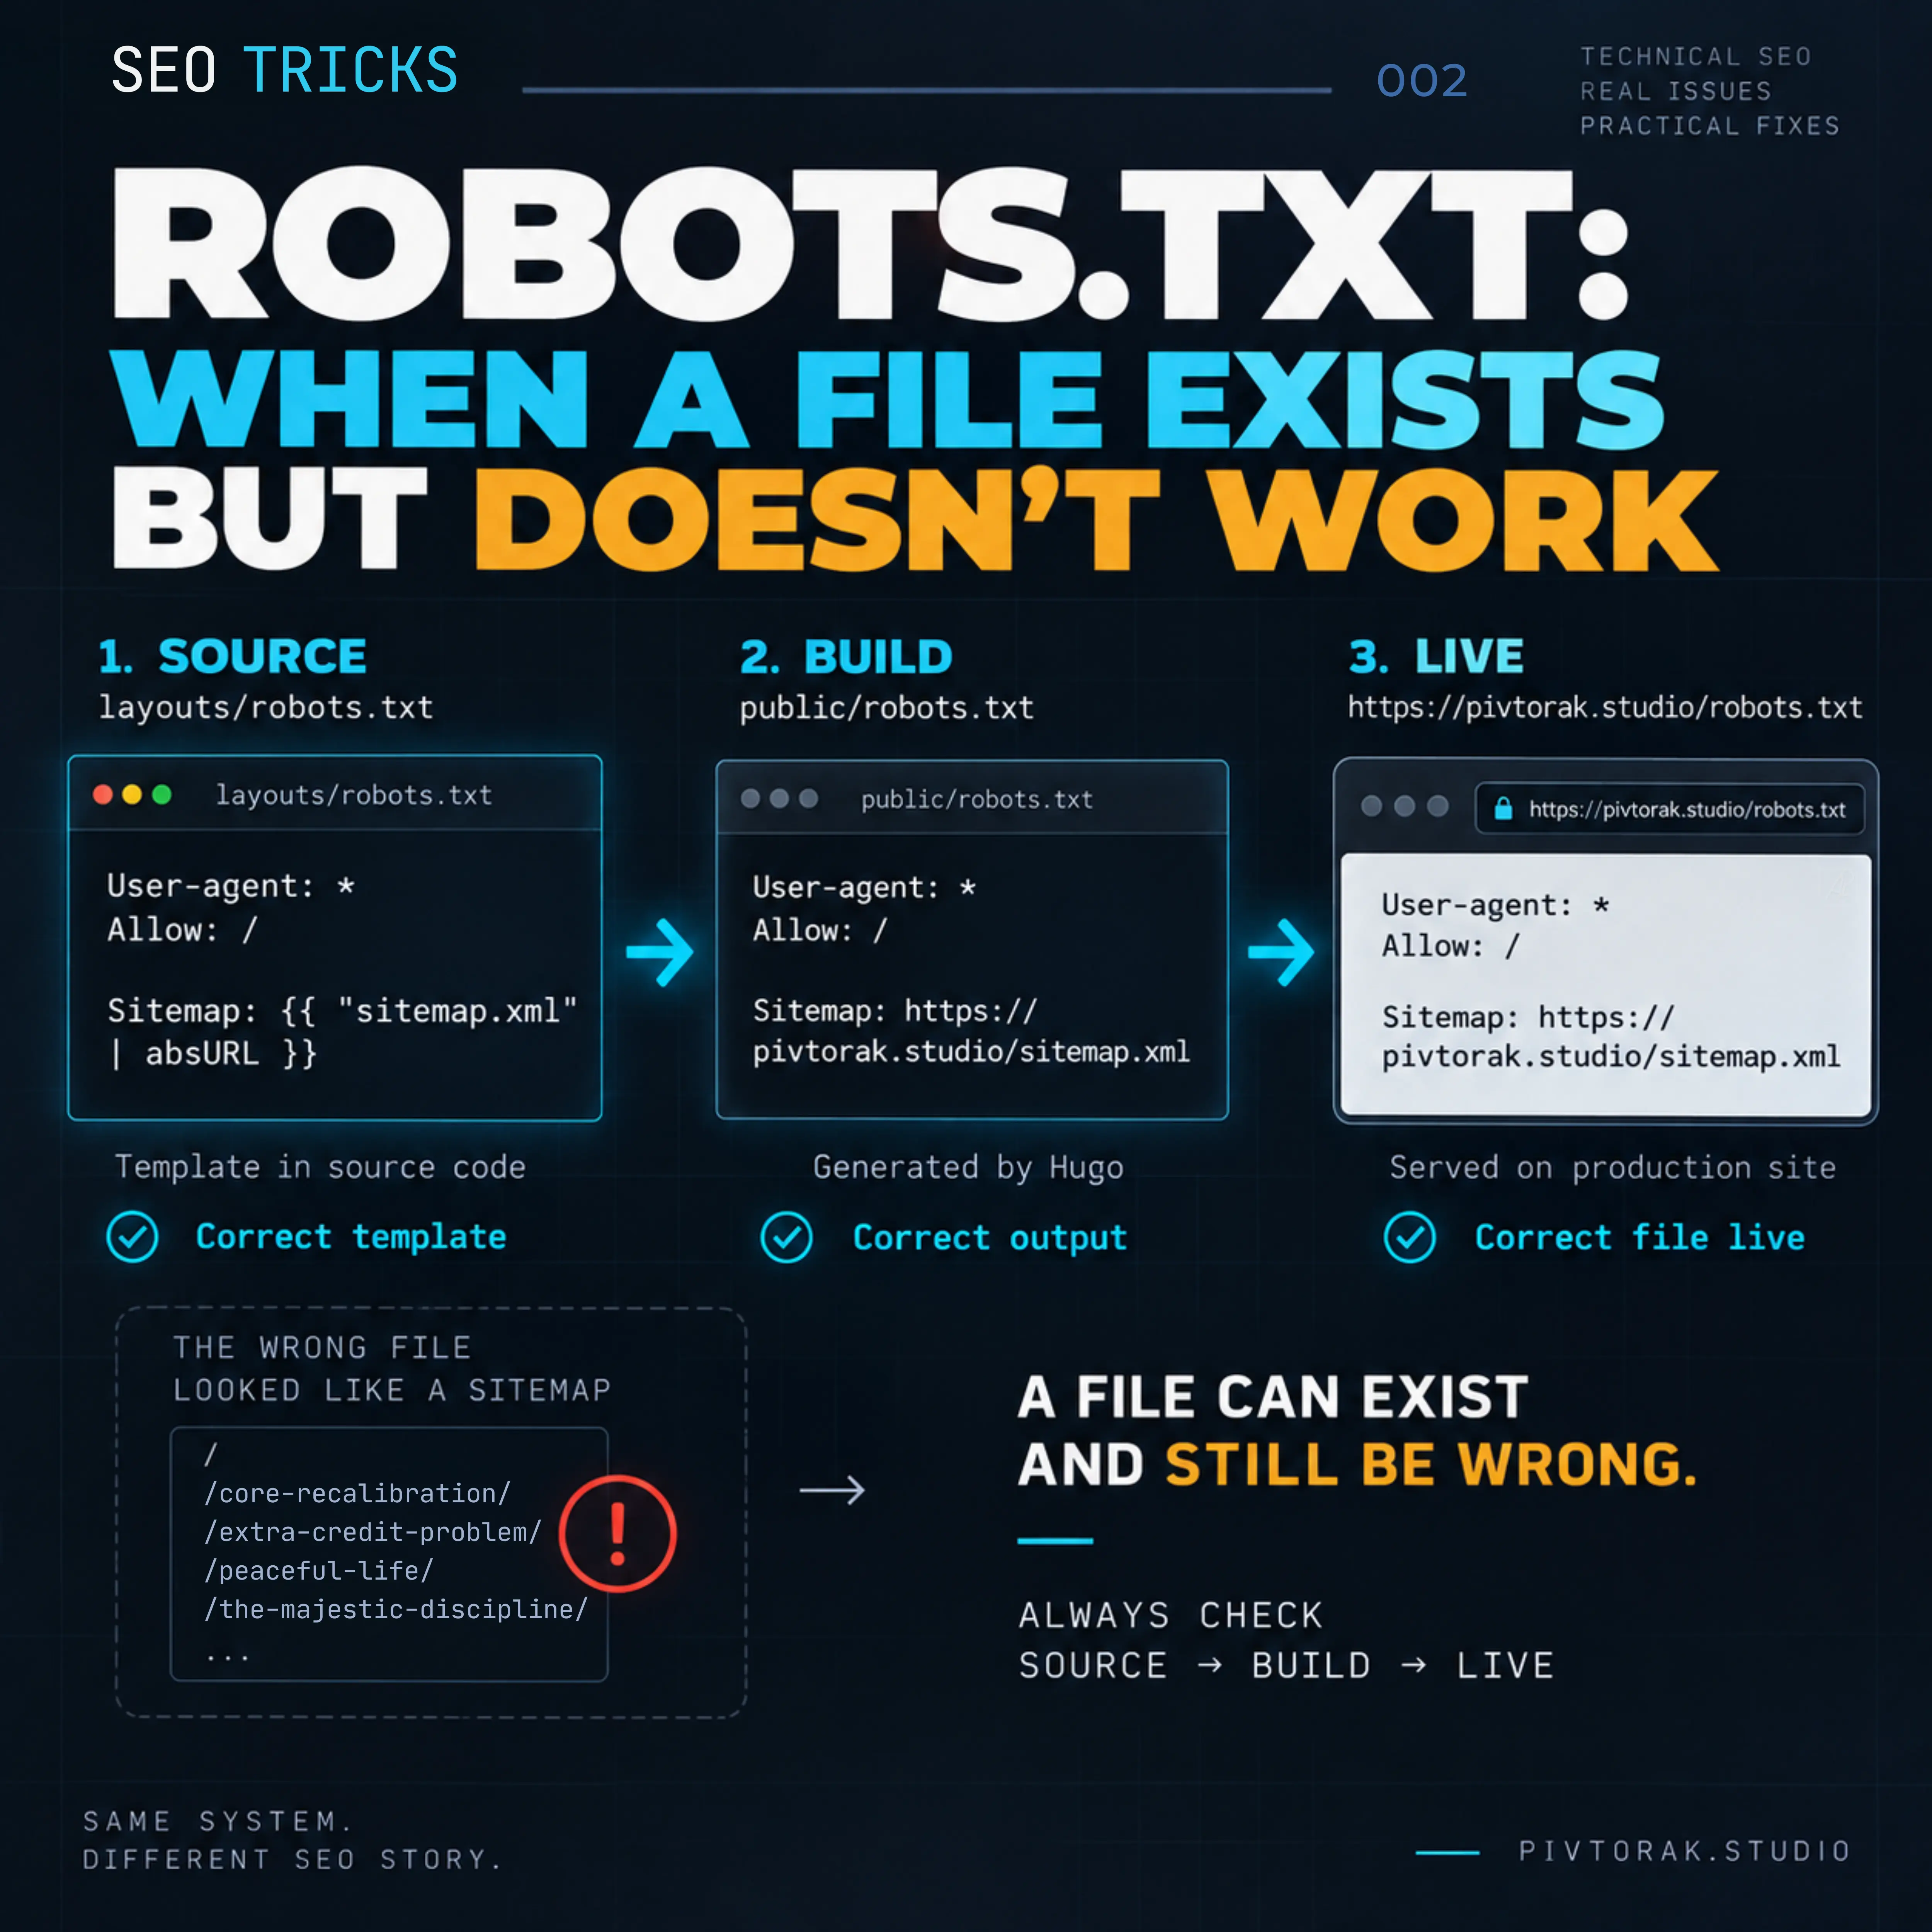
Robots.txt: Коли файл існує, але не працює | SEO Хитрощі#
Файл був на місці. URL був правильним. Сервер його повертав. І все ж — він не виконував того, що мав робити robots.txt.
Короткий огляд#
Файл
robots.txtможе існувати за правильним URL і водночас бути неправильним.У нашому випадку Hugo створював
/robots.txt, але отриманий файл мав приблизно 34 КБ і містив довгий список сторінок сайту замість директив для роботів. Розслідування показало, що несподіваний результат був пов’язаний із пошуком шаблону в Hugo та універсальним шаблономall.txtу теміhugo-book.Рішення виявилося простим: створити явний шаблон
layouts/robots.txt, а потім перевірити результат за схемою Source → Build → Live.
Питання#
Що відбувається, коли robots.txt існує за правильним URL, але його фактичний вміст неправильний?
Саме це питання стало відправною точкою розслідування. Після того як у конфігурації Hugo було підтверджено enableRobotsTXT = true, очікуваний /robots.txt був згенерований — але його вміст не відповідав функціональному robots-файлу.
Проблема вже полягала не в тому, чи існує файл. Питання було в тому, що саме Hugo згенерував.
Чому це важливо#
Для технічного файлу на кшталт robots.txt недостатньо отримати відповідь HTTP 200 або просто переконатися, що файл існує.
Його вміст має виконувати передбачену функцію. Якщо згенерований результат несподіваний, перевірка лише URL може приховати справжню проблему.
Тому в цьому розслідуванні увагу було зосереджено на згенерованому вмісті, вихідному шаблоні та шляху від конфігурації Hugo до кінцевого файлу.
Ми не вимірювали конкретного впливу на crawling, індексацію чи позиції в пошуку, тому це розслідування не стверджує, що неправильний файл спричинив такі наслідки.
Перевірка#
Розслідування почалося з перевірки робочого URL:
https://pivtorak.studio/robots.txtПерша перевірка показала:
404 File not foundВодночас sitemap сайту був доступний. Тому наступне питання стало конкретнішим: чому Hugo не створював очікуваний robots.txt?
1. Перевірка конфігурації Hugo#
Спочатку було перевірено файл hugo.toml.
У конфігурації було:
enableRobotsTXT = trueТобто Hugo був явно налаштований на створення файлу robots.txt.
2. Перевірка явного robots-шаблону#
Наступним кроком був пошук шаблону, який міг визначати вміст цього файлу.
Було перевірено:
layouts/robots.txt
themes/hugo-book/layouts/robots.txt
static/robots.txt
Жодного з цих файлів не існувало.
На цьому етапі конфігурація показувала, що Hugo має створювати robots.txt, але явного шаблону robots.txt не було ані в проєкті, ані в очікуваному місці всередині теми.
3. Збірка сайту#
Потім сайт було зібрано локально:
hugoУ результаті з’явився:
public/robots.txtЦе було важливе відкриття — але ще не успішний результат.
Розмір згенерованого файлу становив приблизно 34 КБ.
Замість невеликого набору robots-директив він містив:
Pivtorak.Studio
- ...
а далі — довгий список сторінок сайту.
Отже, розслідування перейшло від питання:
Чому robots.txt відсутній?до питання:
Чому Hugo генерує цей вміст як robots.txt?4. Перевірка пошуку шаблону#
Після цього розслідування перейшло безпосередньо до теми Hugo.
Було знайдено важливий файл:
themes/hugo-book/layouts/all.txtСаме цей неочікуваний шаблон виявився пов’язаним із отриманим результатом.
Встановився такий технічний ланцюжок:
enableRobotsTXT = true
        ↓
Hugo генерує robots output
        ↓
output type: text/plain
        ↓
пошук шаблону
        ↓
явного шаблону robots.txt немає
        ↓
обирається all.txt
        ↓
неочікуваний вміст стає /robots.txt
Важливо, що згенерований файл не був випадковим або пошкодженим. Hugo справді створював output-файл — але використовував для цього завдання неправильний шаблон.
5. Зупинка перед deployment#
На цьому етапі згенерований public/robots.txt не було закомічено і не було опубліковано.
Файл існував.
Збірка завершилася успішно.
Але вміст був неправильним.
Саме ця відмінність стала головним результатом перевірки:
Успішна збірка ще не доводить, що згенерований файл правильний.
Тому потрібно було перевірити source, потім згенерований результат і лише після цього — live-сайт.
Що ми виявили#
Розслідування показало, що проблема полягала не просто у відсутності robots.txt.
Важливішим виявилося інше:
Hugo створював файл за очікуваним шляхом — але вміст генерувався з неправильного шаблону.
| Перевірка | Очікувалося | Виявлено | Доказ |
|---|---|---|---|
/robots.txt на сайті |
коректний файл robots | спочатку 404 File not found |
перевірка live URL |
| Конфігурація Hugo | enableRobotsTXT = true |
підтверджено | hugo.toml |
| Явний шаблон robots | layouts/robots.txt або інше призначене для нього джерело |
відсутній | перевірка вихідних файлів |
| Локальна збірка | public/robots.txt із robots-директивами |
файл створено, але розміром близько 34 KB | збірка hugo |
| Вміст створеного файлу | User-agent, Allow, Sitemap тощо |
Pivtorak.Studio + довгий список сторінок/URL |
створений public/robots.txt |
| Пошук шаблону | спеціальний шаблон для robots | було задіяно themes/hugo-book/layouts/all.txt |
перевірка теми |
Неочікуваний шаблон#
Розслідування привело до файлу:
themes/hugo-book/layouts/all.txt
Логіка виявилася такою:
hugo.toml
enableRobotsTXT = true
        │
        ▼
Генерація robots-виводу Hugo
        │
        ▼
text/plain
        │
        ▼
Пошук шаблону
        │
        ├── немає явного layouts/robots.txt
        │
        ▼
themes/hugo-book/layouts/all.txt
        │
        ▼
Згенерований файл близько 34 KB
        │
        ▼
Неправильний вміст /robots.txt
Важливо розрізняти дві речі:
Збірка була успішною з точки зору Hugo.
Але результат був невдалим з точки зору призначення файлу.
Що дозволили встановити докази#
- У
hugo.tomlбув присутнійenableRobotsTXT = true. - Явного шаблону
robots.txtу перевірених місцях не було. - Hugo створював
public/robots.txt. - Розмір створеного файлу становив близько 34 KB.
- Замість очікуваних robots-директив файл містив текст, пов’язаний із сайтом, і довгий список сторінок/URL.
- У ході розслідування було виявлено неочікуваний шаблон
themes/hugo-book/layouts/all.txt, який брав участь у формуванні цього виводу. - Неправильний файл було виявлено до коміту та деплою.
Ланцюжок причини:
Robots-вивід Hugo
        ↓
пошук шаблону
        ↓
універсальний all.txt
        ↓
неочікуваний вміст
        ↓
неправильний robots.txt
Що ми не встановлювали#
У межах цього розслідування не вимірювався конкретний вплив проблеми на:
- crawl budget;
- індексацію;
- позиції в пошуковій видачі;
- органічний трафік.
Тому такі наслідки не можна подавати як виміряний результат цього інциденту.
Практичний висновок#
Файл може існувати за правильним URL, успішно створюватися під час збірки — і водночас містити не той вивід, який потрібен для його функції.
Тому перевірки самого існування файлу недостатньо.
Потрібно перевіряти весь ланцюжок:
Source → Build → Live
і дивитися не лише на наявність файлу, а й на його фактичний вміст.
Виправлення#
Виправлення було навмисно простим: замість того щоб покладатися на механізм пошуку шаблонів Hugo при визначенні вмісту /robots.txt, ми створили для цього файлу явний шаблон.
1. Створення явного шаблону robots#
Було створено новий файл:
layouts/robots.txtіз таким вмістом:
User-agent: *
Allow: /

Sitemap: {{ "sitemap.xml" | absURL }}
Це робить очікуваний результат однозначним.
User-agent: *застосовує правила до всіх пошукових роботів.Allow: /дозволяє crawling сайту.Sitemap:вказує абсолютний URL згенерованого sitemap.
Тут важлива не кількість директив. Головне — взяти під контроль шаблон, який генерує /robots.txt.
2. Чому це вирішує проблему#
До виправлення процес генерації виглядав так:
enableRobotsTXT = true
        │
        ▼
Robots output Hugo
        │
        ▼
Пошук шаблону
        │
        ▼
themes/hugo-book/layouts/all.txt
        │
        ▼
Неправильний вміст
        │
        ▼
/robots.txt
Після виправлення:
enableRobotsTXT = true
        │
        ▼
Robots output Hugo
        │
        ▼
layouts/robots.txt
        │
        ▼
Явно задані robots-директиви
        │
        ▼
/robots.txt
Ключовою зміною стало додавання:
layouts/robots.txtЦе усуває неоднозначність, через яку для цього output міг використовуватися універсальний шаблон all.txt.
3. Повний вміст шаблону#
Для відтворюваності рішення повний файл виглядає так:
User-agent: *
Allow: /

Sitemap: {{ "sitemap.xml" | absURL }}
URL sitemap генерується динамічно за допомогою функції absURL Hugo, а не прописується безпосередньо в шаблоні.
4. Важливе правило#
Виправлення не було одразу опубліковане.
Спочатку новий шаблон перевірили локально:
Source → BuildІ лише після того, як згенерований public/robots.txt містив очікувані robots-директиви, результат було переведено на наступний етап:
Build → LiveЦе зберігає головний урок цього інциденту:
Не публікуйте виправлення лише тому, що вихідний код виглядає правильним. Спочатку перевірте згенерований результат.
Перевірка#
Виправлення було перевірено на трьох рівнях:
Source → Build → Live
Кожен рівень відповідав на окреме запитання:
| Рівень | Запитання | Результат |
|---|---|---|
| Source | Чи присутній потрібний шаблон robots? | Так — створено layouts/robots.txt з очікуваними директивами. |
| Build | Чи створює Hugo правильний файл? | Так — згенерований public/robots.txt містив очікувані robots-директиви. |
| Live | Чи потрапив виправлений файл на production-сайт? | Так — live /robots.txt повертав виправлений вміст. |
1. Source#
Спочатку було перевірено вихідний код.
Новий файл:
layouts/robots.txtмістив:
User-agent: *
Allow: /

Sitemap: {{ "sitemap.xml" | absURL }}
На цьому етапі запитання було простим:
Чи присутній потрібний вихідний шаблон у правильному місці та чи містить він правильні інструкції?
Так.
Але самого вихідного коду було недостатньо для підтвердження виправлення.
2. Build#
Далі сайт було локально зібрано командою:
hugoПісля цього безпосередньо перевірили створений файл:
public/robots.txtГоловною зміною стало те, що згенерований output тепер містив robots-директиви, а не попередній список сторінок сайту.
Очікуваний вміст після генерації:
User-agent: *
Allow: /

Sitemap: https://pivtorak.studio/sitemap.xml
Це підтвердило, що вихідний шаблон справді створює потрібний результат.
Таким чином, перехід від:
Source → Build
було здійснено лише після безпосередньої перевірки згенерованого файлу.
3. Live#
Лише після того, як локальна збірка дала правильний результат, зміну було опубліковано.
Після цього було перевірено production URL:
https://pivtorak.studio/robots.txtФінальна відповідь live-сайту:
User-agent: *
Allow: /

Sitemap: https://pivtorak.studio/sitemap.xml
Це підтвердило, що виправлений файл справді потрапив на production-сайт.
4. Доказ деплою#
Публікацію також можна простежити за історією проєкту:
Commit: 8c98ac0a
GitHub Actions run: #2739
Статус: deployment успішно завершено
Це додатково пов’язує перевірену зміну у вихідному коді з результатом на live-сайті.
Ланцюжок перевірки#
SOURCE
layouts/robots.txt
        │
        ▼
BUILD
public/robots.txt
        │
        ▼
LIVE
https://pivtorak.studio/robots.txt
        │
        ▼
Коректні robots-директиви
Що підтверджує ця перевірка#
Перевірка встановлює, що:
- потрібний вихідний шаблон існує;
- Hugo створює очікуваний
robots.txt; - згенерований файл було опубліковано;
- live URL повертає виправлений вміст.
Водночас сама по собі ця перевірка не встановлює подальших змін у crawling, індексації, позиціях у пошуковій видачі чи органічному трафіку.
Для цього потрібні були б окремі вимірювання протягом певного періоду.
Технічне виправлення вважається перевіреним, коли вихідний код створює очікуваний результат під час збірки — і цей результат підтверджено на live-сайті.
Підсумковий висновок#
Проблема з robots.txt не завжди означає, що файл відсутній.
Іноді файл існує.
Іноді Hugo успішно його створює.
І все ж це може бути неправильний файл.
Головний урок цього інциденту простий:
Не перевіряйте лише наявність
/robots.txt. Перевірте, що його створило, що саме згенерував Hugo і що насправді віддає live-сайт.
Надійна послідовність:
Source → Build → Live
У цьому випадку явний шаблон layouts/robots.txt усунув неоднозначність, локальна збірка підтвердила правильність згенерованого output, а live URL підтвердив кінцевий результат.
Файл було виправлено не просто тому, що він почав існувати.
Його було виправлено тому, що його вихідний код, згенерований output і вміст на production-сайті стали відповідати його призначенню.
Фінальна думка#
Успішна збірка — це ще не означає правильний результат.
Завжди перевіряйте файл, який насправді потрапляє у Web.
robots.txt · Hugo · технічний SEO · пошук шаблонів · перевірка сайту
Alt-text:
Темна технічна ілюстрація, що показує розслідування проблеми robots.txt, із кодом, шляхами шаблонів і послідовністю перевірки від вихідного коду через збірку до live-сайту.
SEO Хитрощі. Robots.txt: Коли файл існує, але не працює. AP | Pivtorak.Studio. 22.09.2026
© Анна Півторак (Костюк)