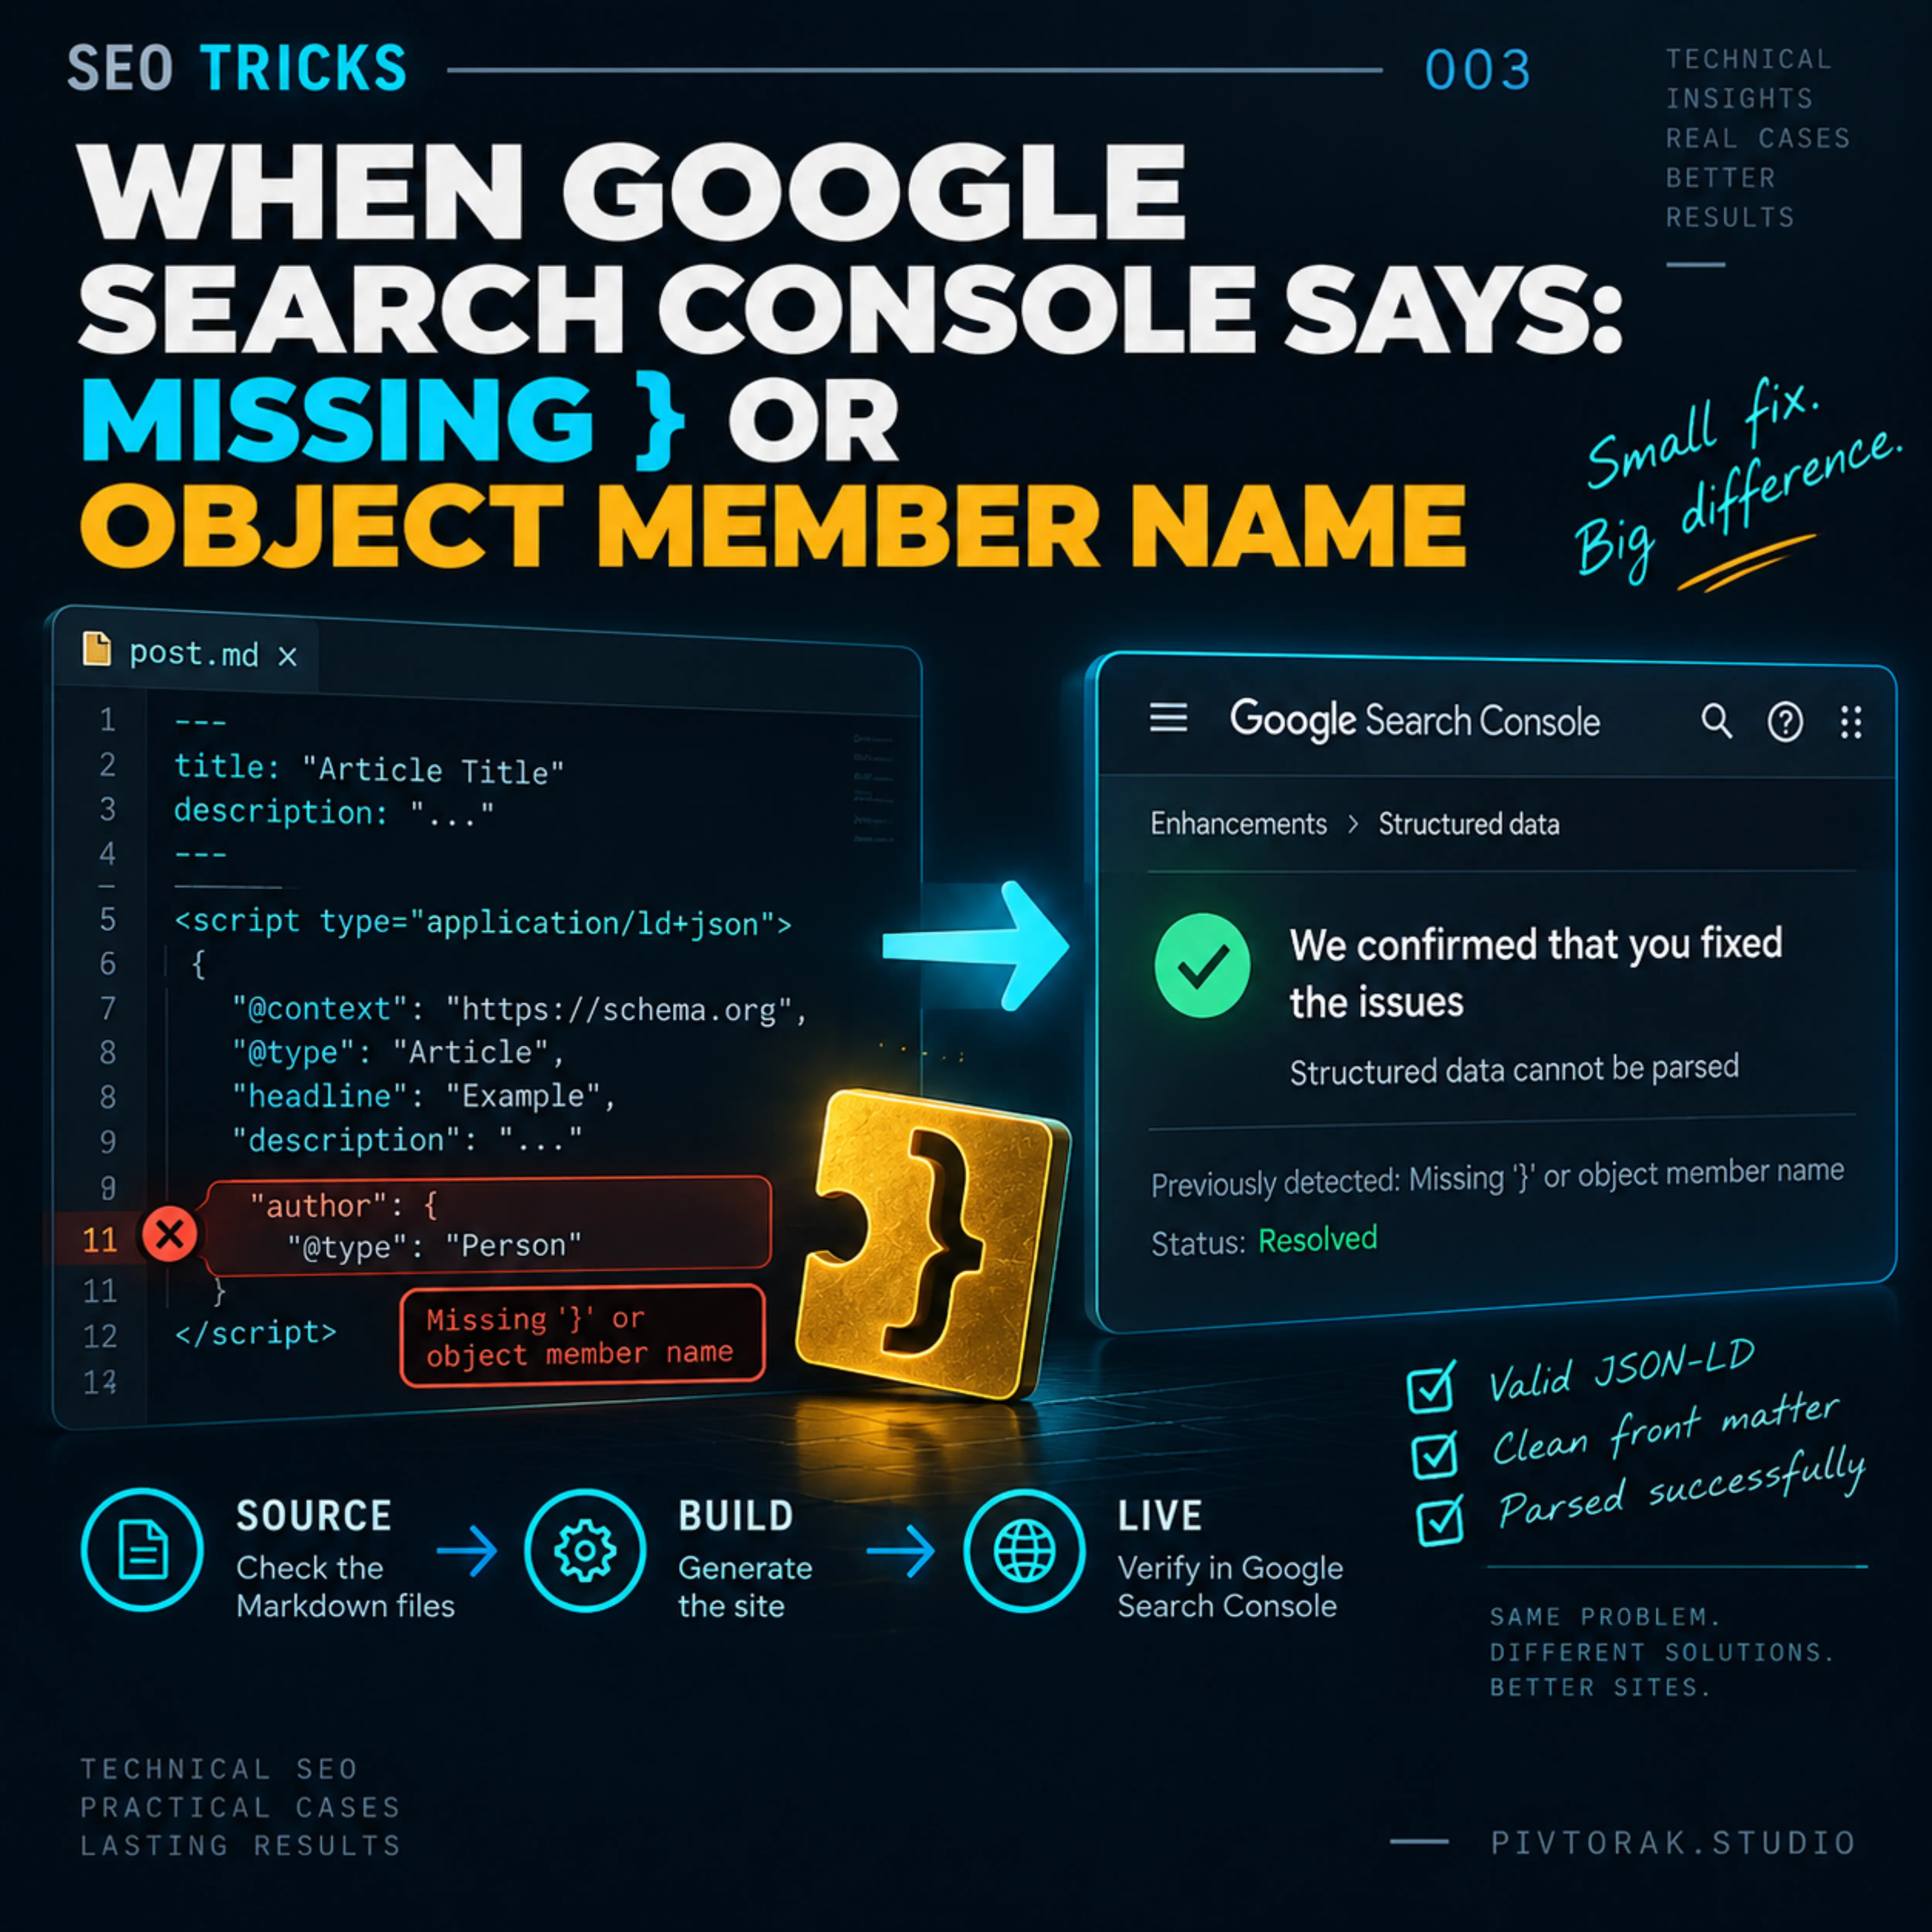
Коли Google Search Console Повідомляє: Немає } або Імені Компонента Об’єкта | SEO Хитрощі#
Іноді достатньо одного пропущеного символу, щоб структуровані дані, які виглядають цілком правильними, стали невидимими для парсера.
Короткий огляд#
Google Search Console повідомив:
Проблема: Структуровані дані не можна проаналізувати
Конкретна помилка: Немає}або імені компонента об’єкта
Проблема була спричинена способом розміщення JSON-LD безпосередньо після YAML front matter у Markdown-файлах. Відсутність порожнього рядка призводила до неправильного аналізу згенерованого вмісту.
Ми перевірили відповідні вихідні файли, виправили форматування, переконалися, що випадкове пошкодження кодування, яке виникло під час виправлення, було повністю відновлено, успішно перебудували сайт і опублікували виправлення. Згодом Google Search Console підтвердив, що проблему вирішено.
Питання#
Що спричинило повідомлення Google Search Console про те, що структуровані дані сайту не можна проаналізувати?
Конкретна помилка звучала так:
Немає
}або імені компонента об’єкта
Потрібно було визначити, чи була проблема безпосередньо в JSON-LD, у шаблонах Hugo, які його формували, чи у способі розміщення JSON-LD у вихідних Markdown-файлах.
Чому це важливо#
Структуровані дані допомагають пошуковим системам розуміти зміст і структуру сторінки. Якщо JSON-LD неможливо проаналізувати, ці структуровані дані не можуть бути надійно оброблені.
Це не означає автоматично, що сторінку неможливо сканувати або індексувати, і не означає, що її позиція в пошуку обов’язково зміниться. Тут проблема конкретніша: самі структуровані дані можуть бути недоступними для пошукових систем у тому вигляді, в якому вони були задуманы.
Тому помилку аналізу варто виправити, особливо якщо один і той самий шаблон у вихідних файлах стосується багатьох сторінок сайту.
Перевірка#
Ми почали з перевірки самих вихідних файлів, не припускаючи наперед, що проблема безпосередньо в JSON-LD.
Перевірка охопила чотири рівні:
- Звіт Google Search Console — щоб визначити точну проблему та повідомлення про помилку.
- Шаблони Hugo — щоб з’ясувати, де формуються структуровані дані та чи не змінюється синтаксис JSON-LD під час генерації сторінок.
- Вихідні Markdown-файли — щоб перевірити, як блоки
<script>з JSON-LD розміщені відносно YAML front matter. - Згенерований HTML — щоб порівняти структуру вихідних файлів із результатом, який фактично створює Hugo.
Пошук у вмісті сайту виявив 565 Markdown-файлів, у яких закривальний роздільник YAML front matter безпосередньо слідував за блоком <script> із JSON-LD, без порожнього рядка:
---
<script type="application/ld+json">
Потім ми перевірили ту саму структуру після додавання порожнього рядка:
---

<script type="application/ld+json">
Згенерований HTML було перевірено на наявність скрипта структурованих даних, а також екранованих JSON-символів, таких як ".
Перевірка показала, що зміни форматування було достатньо, щоб у згенерованому HTML front matter і JSON-LD коректно розділялися.
Що ми виявили#
Розслідування показало, що проблема була не в самому JSON-LD.
Що ми очікували#
Кожен Markdown-файл містив звичайний блок YAML front matter, за яким ішов блок <script> із JSON-LD. Після обробки Hugo структуровані дані мали з’явитися у згенерованому HTML як окремий скрипт.
Що ми спостерігали#
У 565 Markdown-файлах закривальний роздільник YAML front matter безпосередньо слідував за блоком JSON-LD:
---
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  ...
}
</script>
Між завершенням front matter та HTML-елементом <script> не було порожнього рядка.
Цей шаблон повторювався в усіх файлах, яких стосувалася проблема, тому це не був одиничний випадок неправильно сформованого JSON-об’єкта.
Що показали докази#
Ми перевірили той самий вміст після додавання одного порожнього рядка:
---

<script type="application/ld+json">
{
  "@context": "https://schema.org",
  ...
}
</script>
Після повторної збірки сайту за допомогою Hugo згенерований HTML містив JSON-LD як окремий скрипт application/ld+json.
На тестовій сторінці перевірка структурованих даних показала:
application/ld+json: 1 of 1
": No results
Це було важливо, оскільки показало, що JSON-LD потрапляв у згенерований HTML в очікуваному форматі, а не некоректно об’єднувався з розташованим перед ним front matter.
Що спричинило проблему#
Отже, причиною була не відсутня } всередині JSON-LD-об’єкта.
Проблема полягала у відсутності розділення між YAML front matter і наступним блоком <script> JSON-LD у вихідних Markdown-файлах.
Оскільки один і той самий шаблон був присутній у 565 файлах, проблема потенційно могла впливати на структуровані дані значної частини сайту.
Розслідування також показало важливий практичний момент: коли пошукова система повідомляє про помилку аналізу JSON, текст повідомлення не обов’язково вказує на фактичне джерело проблеми. У нашому випадку згадка про відсутню } спрямовувала увагу безпосередньо на JSON-об’єкт, але докази показали, що проблема знаходилася на межі між Markdown front matter і блоком JSON-LD.
Виправлення#
Виправлення було навмисно простим: додати один порожній рядок між закривальним роздільником YAML front matter та блоком <script> JSON-LD у кожному Markdown-файлі, якого стосувалася проблема.
До#
---
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  ...
}
</script>Після#
---

<script type="application/ld+json">
{
  "@context": "https://schema.org",
  ...
}
</script>
Файли, яких стосувалася проблема, знаходилися в каталогах контенту сайту. Загалом 565 Markdown-файлів містили саме таку структуру.
Замість редагування файлів по одному ми систематично застосували виправлення до всіх файлів, яких це стосувалося.
Важливе ускладнення#
Під час першої масової операції редагування обробка кодування у Windows PowerShell спричинила появу UTF-8 mojibake у файлах, яких це стосувалося. Такі символи, як:
—
’
©
ðŸ...
з’явилися замість оригінальних Unicode-символів.
Ми зупинили процес, виявили проблему з кодуванням і відновили пошкоджені файли за допомогою зворотного перетворення CP1252/UTF-8. Подальша перевірка показала:
Файлів, у яких залишився mojibake: 0Після цього ми перевірили git diff, щоб переконатися, що вихідний вміст не було змінено. Фінальний diff показав, що фактичною зміною було додавання одного порожнього рядка до кожного файлу, якого це стосувалося.
Підсумковий результат#
Виправлення дало:
565 files changed, 565 insertions(+)Після цього Hugo успішно зібрав сайт.
Потім, після перевірки вихідних файлів, зміни було закомічено та відправлено на GitHub:
915f05fa Add spacing between front matter and JSON-LDОтже, суть виправлення полягала не у зміні самих JSON-LD-об’єктів, а в тому, щоб відокремити YAML front matter від наступного за ним блоку JSON-LD у вихідних Markdown-файлах.
Перевірка результату#
Перевірка пройшла за повною послідовністю:
Source → Build → Live
Source#
Після виправлення ми перевірили файли Markdown, яких це стосувалося, та git diff.
Фінальний diff підтвердив, що передбачена зміна обмежувалася додаванням одного порожнього рядка між YAML front matter і блоком JSON-LD у кожному файлі.
Усі 565 файлів, яких стосувалася проблема, були включені до коміту:
915f05fa Add spacing between front matter and JSON-LDBuild#
Після виправлення сайт було повторно зібрано за допомогою Hugo.
Збірка завершилася успішно. Наявні попередження Hugo про застарілі функції залишилися, але вони не були пов’язані з проблемою структурованих даних і не перешкоджали збірці.
Ми також перевірили, що після відновлення кодування mojibake більше не залишилося:
Файлів, у яких залишився mojibake: 0Після цього виправлений вміст було відправлено на GitHub:
bde59e67..915f05fa main -> mainLive#
Останню й найважливішу перевірку виконав сам Google Search Console.
Згодом Google надіслав підтвердження, що проблему вирішено:
Ми підтвердили, що Ви вирішили проблеми: Structured data cannot be parsed.
Конкретна помилка, про яку Google повідомляв раніше:
Немає
}або імені компонента об’єкта
Google підтвердив виправлення на сторінці, яку повторно перевірив.
Це найвищий рівень перевірки, доступний у цьому випадку: вихідні файли було виправлено, сайт успішно зібрано, виправлену версію опубліковано, а Google Search Console незалежно підтвердив, що проблему аналізу структурованих даних на опублікованому сайті усунуто.
Результат#
Source → виправлено
Build → успішно виконано
Live → перевірено Google Search Console ✅
Важливо розрізняти ці рівні: перші дві перевірки показали, що наше виправлення технічно працює; фінальне підтвердження Google показало, що пошукова система прийняла виправлені структуровані дані на опублікованому сайті.
Підсумок#
Головний висновок простий: якщо Google повідомляє про помилку аналізу структурованих даних, не варто одразу припускати, що сам JSON-LD-об’єкт сформований неправильно. Потрібно перевірити весь шлях — від вихідного Markdown до згенерованого HTML.
У нашому випадку одного відсутнього порожнього рядка між YAML front matter і блоком <script> JSON-LD було достатньо, щоб спричинити проблему аналізу у 565 файлах. Виправлення було невеликим, але для пошуку справжньої причини довелося перевірити вихідні файли, збірку Hugo, згенерований HTML і, нарешті, опублікований сайт через Google Search Console.
Іноді помилка вказує на JSON. А справжня проблема може бути безпосередньо перед ним.
Google Search Console · структуровані дані · JSON-LD · Hugo · SEO-налагодження
Alt-text:
Google Search Console підтверджує, що проблему аналізу структурованих даних на опублікованому сайті вирішено.
SEO Хитрощі. Коли Google Search Console Повідомляє: Немає } або імені компонента об’єкта. AP | Pivtorak.Studio. 22.09.2026
© Анна Півторак (Костюк)