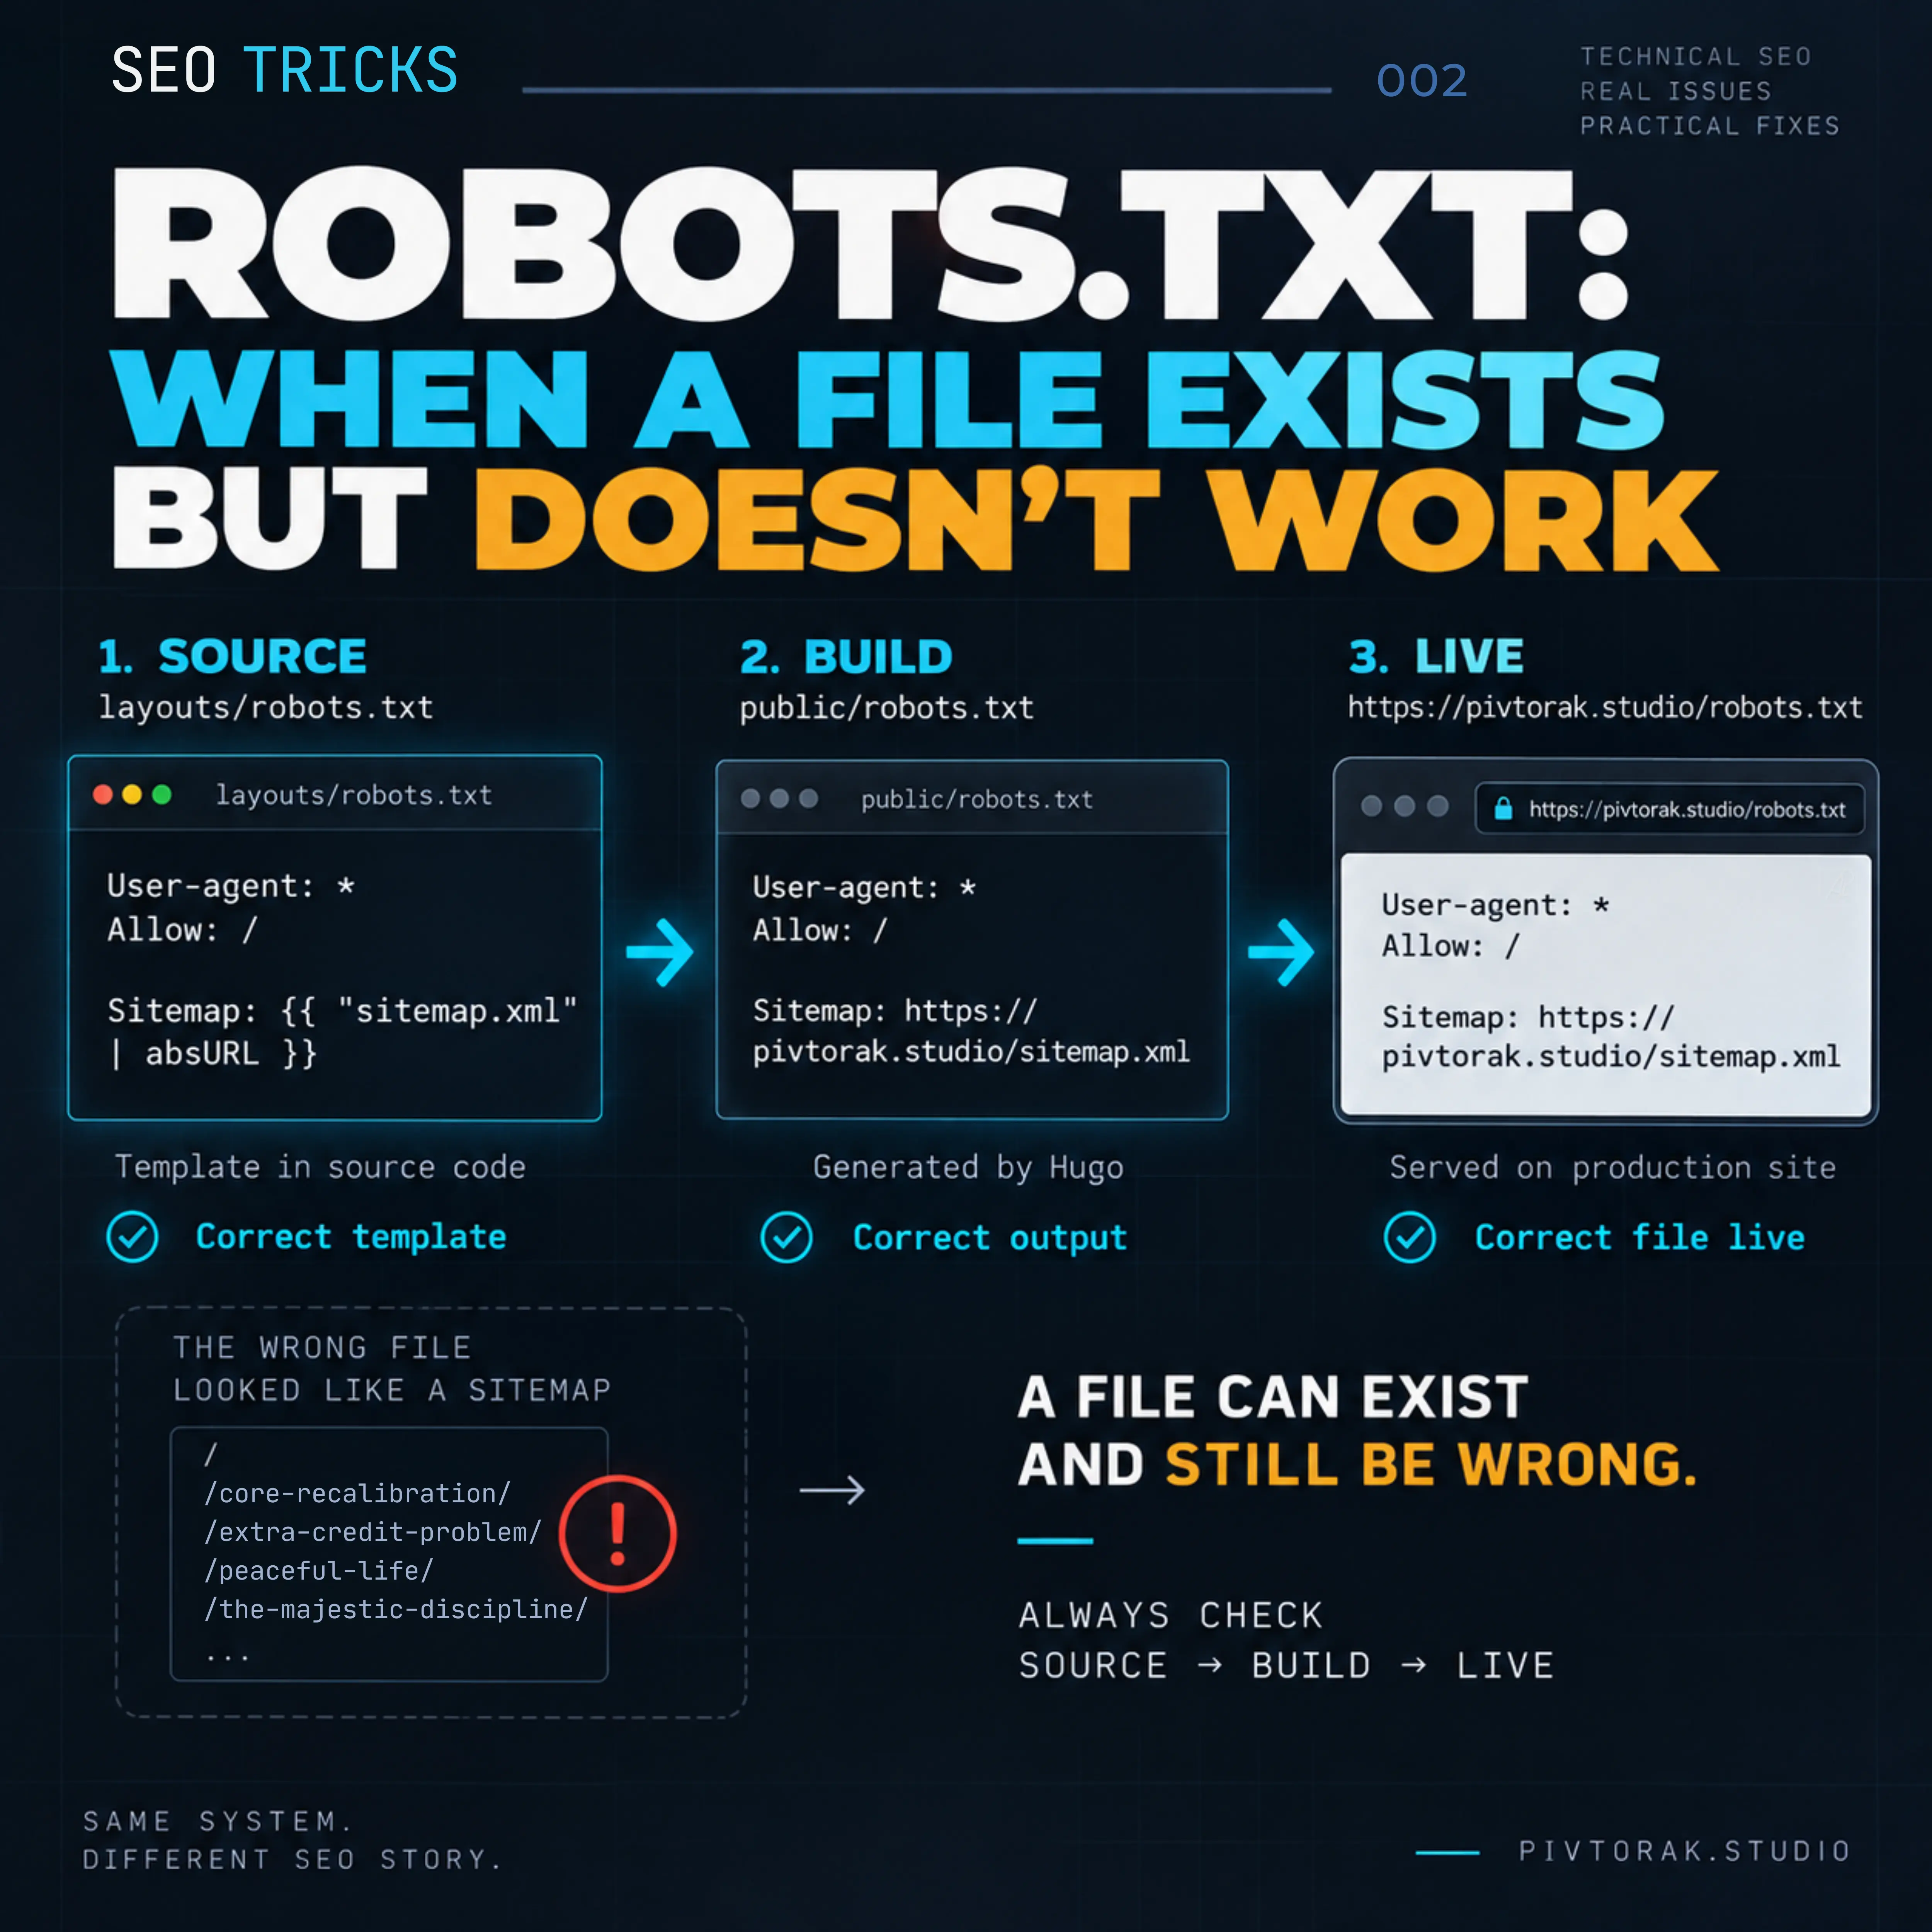
Robots.txt: Quando um Ficheiro Existe, mas Não Funciona | Truques de SEO#
O ficheiro estava lá. O URL estava correto. O servidor devolvia-o. E, no entanto — não estava a fazer aquilo que o robots.txt deveria fazer.
Caixa de Resumo Rápido#
Um ficheiro
robots.txtpode existir no URL correto e, ainda assim, estar errado.Neste caso, o Hugo gerava
/robots.txt, mas o ficheiro resultante tinha cerca de 34 KB e continha uma longa lista de páginas do site em vez de diretivas para os robots. A investigação identificou a origem do conteúdo inesperado no sistema de procura de templates do Hugo e num template genéricoall.txtdo temahugo-book.A solução foi simples: criar um template explícito
layouts/robots.txte verificar o resultado através de Source → Build → Live.
A Questão#
O que acontece quando o robots.txt existe no URL correto, mas o seu conteúdo está errado?
Foi esta a questão que esteve na origem da investigação. Depois de confirmarmos enableRobotsTXT = true na configuração do Hugo, o /robots.txt esperado foi gerado — mas o seu conteúdo não correspondia a um ficheiro robots funcional.
O problema já não era saber se o ficheiro existia. A questão era o que o Hugo tinha realmente gerado.
Porque é Importante#
Para um ficheiro técnico como o robots.txt, uma resposta HTTP 200 ou a simples existência do ficheiro não são suficientes.
O conteúdo tem de cumprir a função pretendida. Se o resultado gerado for inesperado, verificar apenas o URL pode esconder o verdadeiro problema.
Por isso, nesta investigação, o foco passou para o conteúdo gerado, para o template de origem e para o percurso entre a configuração do Hugo e o ficheiro final.
Não medimos nenhum impacto específico no crawling, na indexação ou nos rankings, pelo que esta investigação não afirma que o ficheiro incorreto tenha provocado esses efeitos.
A Verificação#
A investigação começou pelo URL ativo:
https://pivtorak.studio/robots.txtA primeira verificação mostrou:
404 File not foundAo mesmo tempo, o sitemap do site estava disponível. Isto tornou a questão mais específica: porque é que o Hugo não estava a gerar o robots.txt esperado?
1. Verificar a configuração do Hugo#
Primeiro, foi analisado o ficheiro hugo.toml do site.
A configuração continha:
enableRobotsTXT = trueIsto significava que o Hugo estava explicitamente configurado para gerar um ficheiro robots.txt.
2. Verificar se existia um template específico para robots#
O passo seguinte foi procurar um template que pudesse definir o conteúdo desse ficheiro.
Foram verificados:
layouts/robots.txt
themes/hugo-book/layouts/robots.txt
static/robots.txt
Nenhum destes ficheiros existia.
Neste ponto, a configuração indicava que o Hugo deveria gerar o robots.txt, mas não existia um template robots.txt explícito nem no projeto nem no local esperado do tema.
3. Fazer o build do site#
Em seguida, o site foi compilado localmente:
hugoO build criou:
public/robots.txtEsta foi uma descoberta importante — mas ainda não era um resultado bem-sucedido.
O ficheiro gerado tinha aproximadamente 34 KB.
Em vez de conter um pequeno conjunto de diretivas para robots, continha:
Pivtorak.Studio
- ...
seguido de uma longa lista de páginas do site.
Assim, a investigação passou de:
Porque é que o robots.txt está em falta?para:
Porque é que o Hugo está a gerar este conteúdo como robots.txt?4. Analisar a procura do template#
A investigação passou então para o tema Hugo.
Foi encontrado um ficheiro relevante em:
themes/hugo-book/layouts/all.txtEste era o template inesperado envolvido no resultado gerado.
A cadeia técnica identificada foi:
enableRobotsTXT = true
        ↓
Hugo gera o output de robots
        ↓
output type: text/plain
        ↓
procura do template
        ↓
não existe um template robots.txt explícito
        ↓
all.txt é selecionado
        ↓
conteúdo inesperado torna-se /robots.txt
O ponto importante é que o ficheiro gerado não estava aleatório nem corrompido. O Hugo estava a gerar corretamente um ficheiro de output — mas estava a utilizar o template errado para a finalidade pretendida.
5. Parar antes do deployment#
Nesta fase, o public/robots.txt gerado não foi submetido ao Git nem colocado em produção.
O ficheiro existia.
O build tinha terminado com sucesso.
Mas o conteúdo estava errado.
Esta distinção tornou-se a principal descoberta da investigação:
Um build concluído com sucesso não prova que o ficheiro gerado esteja correto.
Era necessário verificar a origem, o resultado gerado e só depois o site em produção.
O Que Descobrimos#
A investigação demonstrou que o problema não era simplesmente o facto de o robots.txt estar em falta.
A descoberta mais importante foi esta:
O Hugo estava a gerar um ficheiro no caminho esperado — mas o conteúdo gerado vinha do template errado.
Esperado vs. Observado#
| Verificação | Esperado | Observado | Evidência |
|---|---|---|---|
/robots.txt em produção |
Um ficheiro robots válido | Inicialmente devolvia 404 |
Verificação do URL ativo |
| Configuração do Hugo | enableRobotsTXT = true |
Confirmado | hugo.toml |
| Template explícito para robots | layouts/robots.txt ou outra origem destinada a esse fim |
Não existia | Inspeção dos ficheiros-fonte |
| Build local | public/robots.txt com diretivas para robots |
O ficheiro foi gerado, mas tinha cerca de 34 KB | Build com hugo |
| Conteúdo gerado | User-agent, Allow, Sitemap, etc. |
Pivtorak.Studio seguido de uma longa lista de páginas/URLs |
public/robots.txt gerado |
| Investigação dos templates | Um template específico para robots deveria controlar o output | themes/hugo-book/layouts/all.txt foi utilizado |
Inspeção do tema |
A principal evidência foi o próprio ficheiro gerado.
A sua existência demonstrava que o Hugo estava a produzir o output solicitado. O seu conteúdo demonstrava que esse output não estava a funcionar como pretendido.
O template inesperado#
A investigação identificou:
themes/hugo-book/layouts/all.txtcomo o template inesperado envolvido no resultado.
O research também registou o output de robots do Hugo como text/plain e o comportamento relevante da procura de templates.
A cadeia técnica ficou assim:
hugo.toml
enableRobotsTXT = true
        │
        ▼
Hugo gera o output de robots
        │
        ▼
text/plain
        │
        ▼
Procura do template
        │
        ├── não existe layouts/robots.txt explícito
        │
        ▼
themes/hugo-book/layouts/all.txt
        │
        ▼
Output gerado de 34 KB
        │
        ▼
Conteúdo incorreto em /robots.txt
Isto explica uma distinção importante:
O build foi concluído com sucesso do ponto de vista do Hugo. O resultado não foi bem-sucedido do ponto de vista da função pretendida para o ficheiro.
O que as evidências permitiram concluir#
Foi possível confirmar todos os seguintes pontos:
enableRobotsTXT = trueestava presente.- Não existia um template
robots.txtexplícito nos locais verificados. - O Hugo gerou
public/robots.txtdurante o build local. - O ficheiro gerado tinha aproximadamente 34 KB.
- O seu conteúdo era constituído por texto relacionado com o site e uma longa lista de páginas/URLs, em vez das diretivas robots esperadas.
- A investigação identificou
themes/hugo-book/layouts/all.txtcomo o template inesperado envolvido nesse output. - O ficheiro gerado incorretamente foi detetado antes do commit e do deployment.
Assim, a causa identificada pela investigação foi:
Hugo robots output
        ↓
procura do template
        ↓
all.txt
        ↓
conteúdo inesperado
        ↓
robots.txt incorreto
O que não foi estabelecido#
A investigação não mediu qualquer efeito específico sobre:
- crawl budget;
- indexação;
- posições nos resultados de pesquisa;
- tráfego orgânico.
Por isso, esses efeitos não devem ser apresentados como consequências deste incidente específico.
O que foi efetivamente demonstrado é mais simples — e mais útil:
Um ficheiro pode existir no URL correto, ser gerado com sucesso pelo build e, ainda assim, conter o output errado.
É por isso que verificar apenas a existência do ficheiro não foi suficiente — foi necessário inspecionar o conteúdo gerado antes do deployment.
A Correção#
A correção foi deliberadamente simples: em vez de depender da procura de templates do Hugo para determinar o que deveria tornar-se /robots.txt, criámos um template explícito para este ficheiro.
1. Criar um template explícito para robots#
Foi criado um novo ficheiro:
layouts/robots.txtcom o seguinte conteúdo:
User-agent: *
Allow: /

Sitemap: {{ "sitemap.xml" | absURL }}
Isto torna explícito qual deve ser o resultado.
User-agent: *aplica as regras a todos os crawlers.Allow: /permite o crawling do site.Sitemap:fornece o URL absoluto do sitemap gerado.
O ponto importante não é adicionar mais diretivas. É assumir o controlo do template que gera /robots.txt.
2. Porque é que isto resolve o problema#
Antes da correção, o processo de geração era:
enableRobotsTXT = true
        │
        ▼
Robots output do Hugo
        │
        ▼
Procura do template
        │
        ▼
themes/hugo-book/layouts/all.txt
        │
        ▼
Conteúdo incorreto
        │
        ▼
/robots.txt
Depois da correção:
enableRobotsTXT = true
        │
        ▼
Robots output do Hugo
        │
        ▼
layouts/robots.txt
        │
        ▼
Diretivas robots explícitas
        │
        ▼
/robots.txt
A alteração essencial é a adição de:
layouts/robots.txtIsto elimina a ambiguidade que permitia que o template genérico all.txt fosse utilizado para este output.
3. O template completo#
Para permitir a reprodução da solução, o ficheiro completo é:
User-agent: *
Allow: /

Sitemap: {{ "sitemap.xml" | absURL }}
O URL do sitemap é gerado dinamicamente através da função absURL do Hugo, em vez de o domínio de produção ser escrito diretamente no template.
4. Uma regra importante#
A correção não foi imediatamente publicada.
O novo template teve primeiro de ser verificado localmente:
Source → BuildSó depois de o public/robots.txt gerado conter as diretivas robots esperadas é que o resultado passou para:
Build → LiveIsto preserva a principal lição deste incidente:
Não publique uma correção apenas porque o código-fonte parece correto. Verifique primeiro o resultado gerado.
Verificação#
A correção foi verificada em três níveis:
Source → Build → Live
Cada nível respondeu a uma pergunta diferente:
| Nível | Pergunta | Resultado |
|---|---|---|
| Source | O template robots pretendido está presente? | Sim — foi criado layouts/robots.txt com as diretivas esperadas. |
| Build | O Hugo gera o ficheiro correto? | Sim — o public/robots.txt gerado continha as diretivas robots esperadas. |
| Live | O ficheiro corrigido chegou ao site de produção? | Sim — o /robots.txt em produção devolveu o conteúdo corrigido. |
1. Source#
Primeiro, foi verificado o código-fonte.
O novo ficheiro:
layouts/robots.txtcontinha:
User-agent: *
Allow: /

Sitemap: {{ "sitemap.xml" | absURL }}
Nesta fase, a pergunta era simplesmente:
O template de origem pretendido está correto e encontra-se no local esperado?
Sim.
Mas o código-fonte, por si só, não foi considerado evidência suficiente.
2. Build#
Em seguida, o site foi compilado localmente com:
hugoO ficheiro gerado:
public/robots.txtfoi então verificado diretamente.
A alteração importante foi que o output gerado passou a conter as diretivas robots, em vez da lista anterior de páginas do site.
Conteúdo esperado após a geração:
User-agent: *
Allow: /

Sitemap: https://pivtorak.studio/sitemap.xml
Isto confirmou que o template de origem estava efetivamente a produzir o resultado pretendido.
Assim, a verificação avançou de:
Source → Build
apenas depois de o ficheiro gerado ter sido inspecionado.
3. Live#
Só depois de a compilação local produzir o resultado correto é que a alteração foi publicada.
O URL de produção foi então verificado:
https://pivtorak.studio/robots.txtA resposta final em produção foi:
User-agent: *
Allow: /

Sitemap: https://pivtorak.studio/sitemap.xml
Isto confirmou que o ficheiro corrigido tinha chegado ao site em produção.
4. Evidência do deployment#
A publicação também pode ser rastreada através do histórico do projeto:
Commit: 8c98ac0a
GitHub Actions run: #2739
Estado: deployment concluído com sucesso
Isto fornece uma ligação adicional entre a alteração verificada no código-fonte e o resultado no site em produção.
Cadeia de verificação#
SOURCE
layouts/robots.txt
        │
        ▼
BUILD
public/robots.txt
        │
        ▼
LIVE
https://pivtorak.studio/robots.txt
        │
        ▼
Diretivas robots corretas
O que esta verificação demonstra#
A verificação estabelece que:
- o template de origem pretendido existe;
- o Hugo gera o
robots.txtesperado; - o ficheiro gerado foi publicado;
- o URL em produção devolve o conteúdo corrigido.
Isto não estabelece, por si só, qualquer alteração posterior no crawling, na indexação, nas posições nos resultados de pesquisa ou no tráfego orgânico.
Esses efeitos exigiriam medições separadas ao longo do tempo.
Uma correção técnica é verificada quando a origem pretendida produz o resultado esperado na compilação — e esse resultado é confirmado no site em produção.
Conclusão Final#
Um problema com o robots.txt nem sempre significa que o ficheiro está em falta.
Por vezes, o ficheiro existe.
Por vezes, o Hugo gera-o com sucesso.
E, ainda assim, continua a ser o ficheiro errado.
A principal lição deste incidente é simples:
Não verifique apenas se
/robots.txtexiste. Verifique o que o gerou, o que o Hugo produziu e o que o site em produção realmente disponibiliza.
A sequência fiável é:
Source → Build → Live
Neste caso, a criação de um layouts/robots.txt explícito eliminou a ambiguidade, a compilação local confirmou o output gerado e o URL em produção confirmou o resultado final.
O ficheiro não foi corrigido simplesmente porque passou a existir.
Foi corrigido porque a sua origem, o output gerado e o conteúdo em produção passaram a corresponder à sua função pretendida.
Pensamento Final#
Uma compilação bem-sucedida não é o mesmo que um resultado correto.
Verifique sempre o ficheiro que realmente chega à Web.
robots.txt · Hugo · SEO técnico · procura de templates · verificação do site
Alt-text:
Uma ilustração técnica escura que mostra uma investigação de robots.txt, com código, caminhos de templates e um fluxo de verificação desde o código-fonte até à compilação e ao site em produção.
Truques de SEO. Robots.txt: Quando um Ficheiro Existe, mas Não Funciona. AP | Pivtorak.Studio. 22.09.2026
© Anna Pivtorak (Kostyuk)