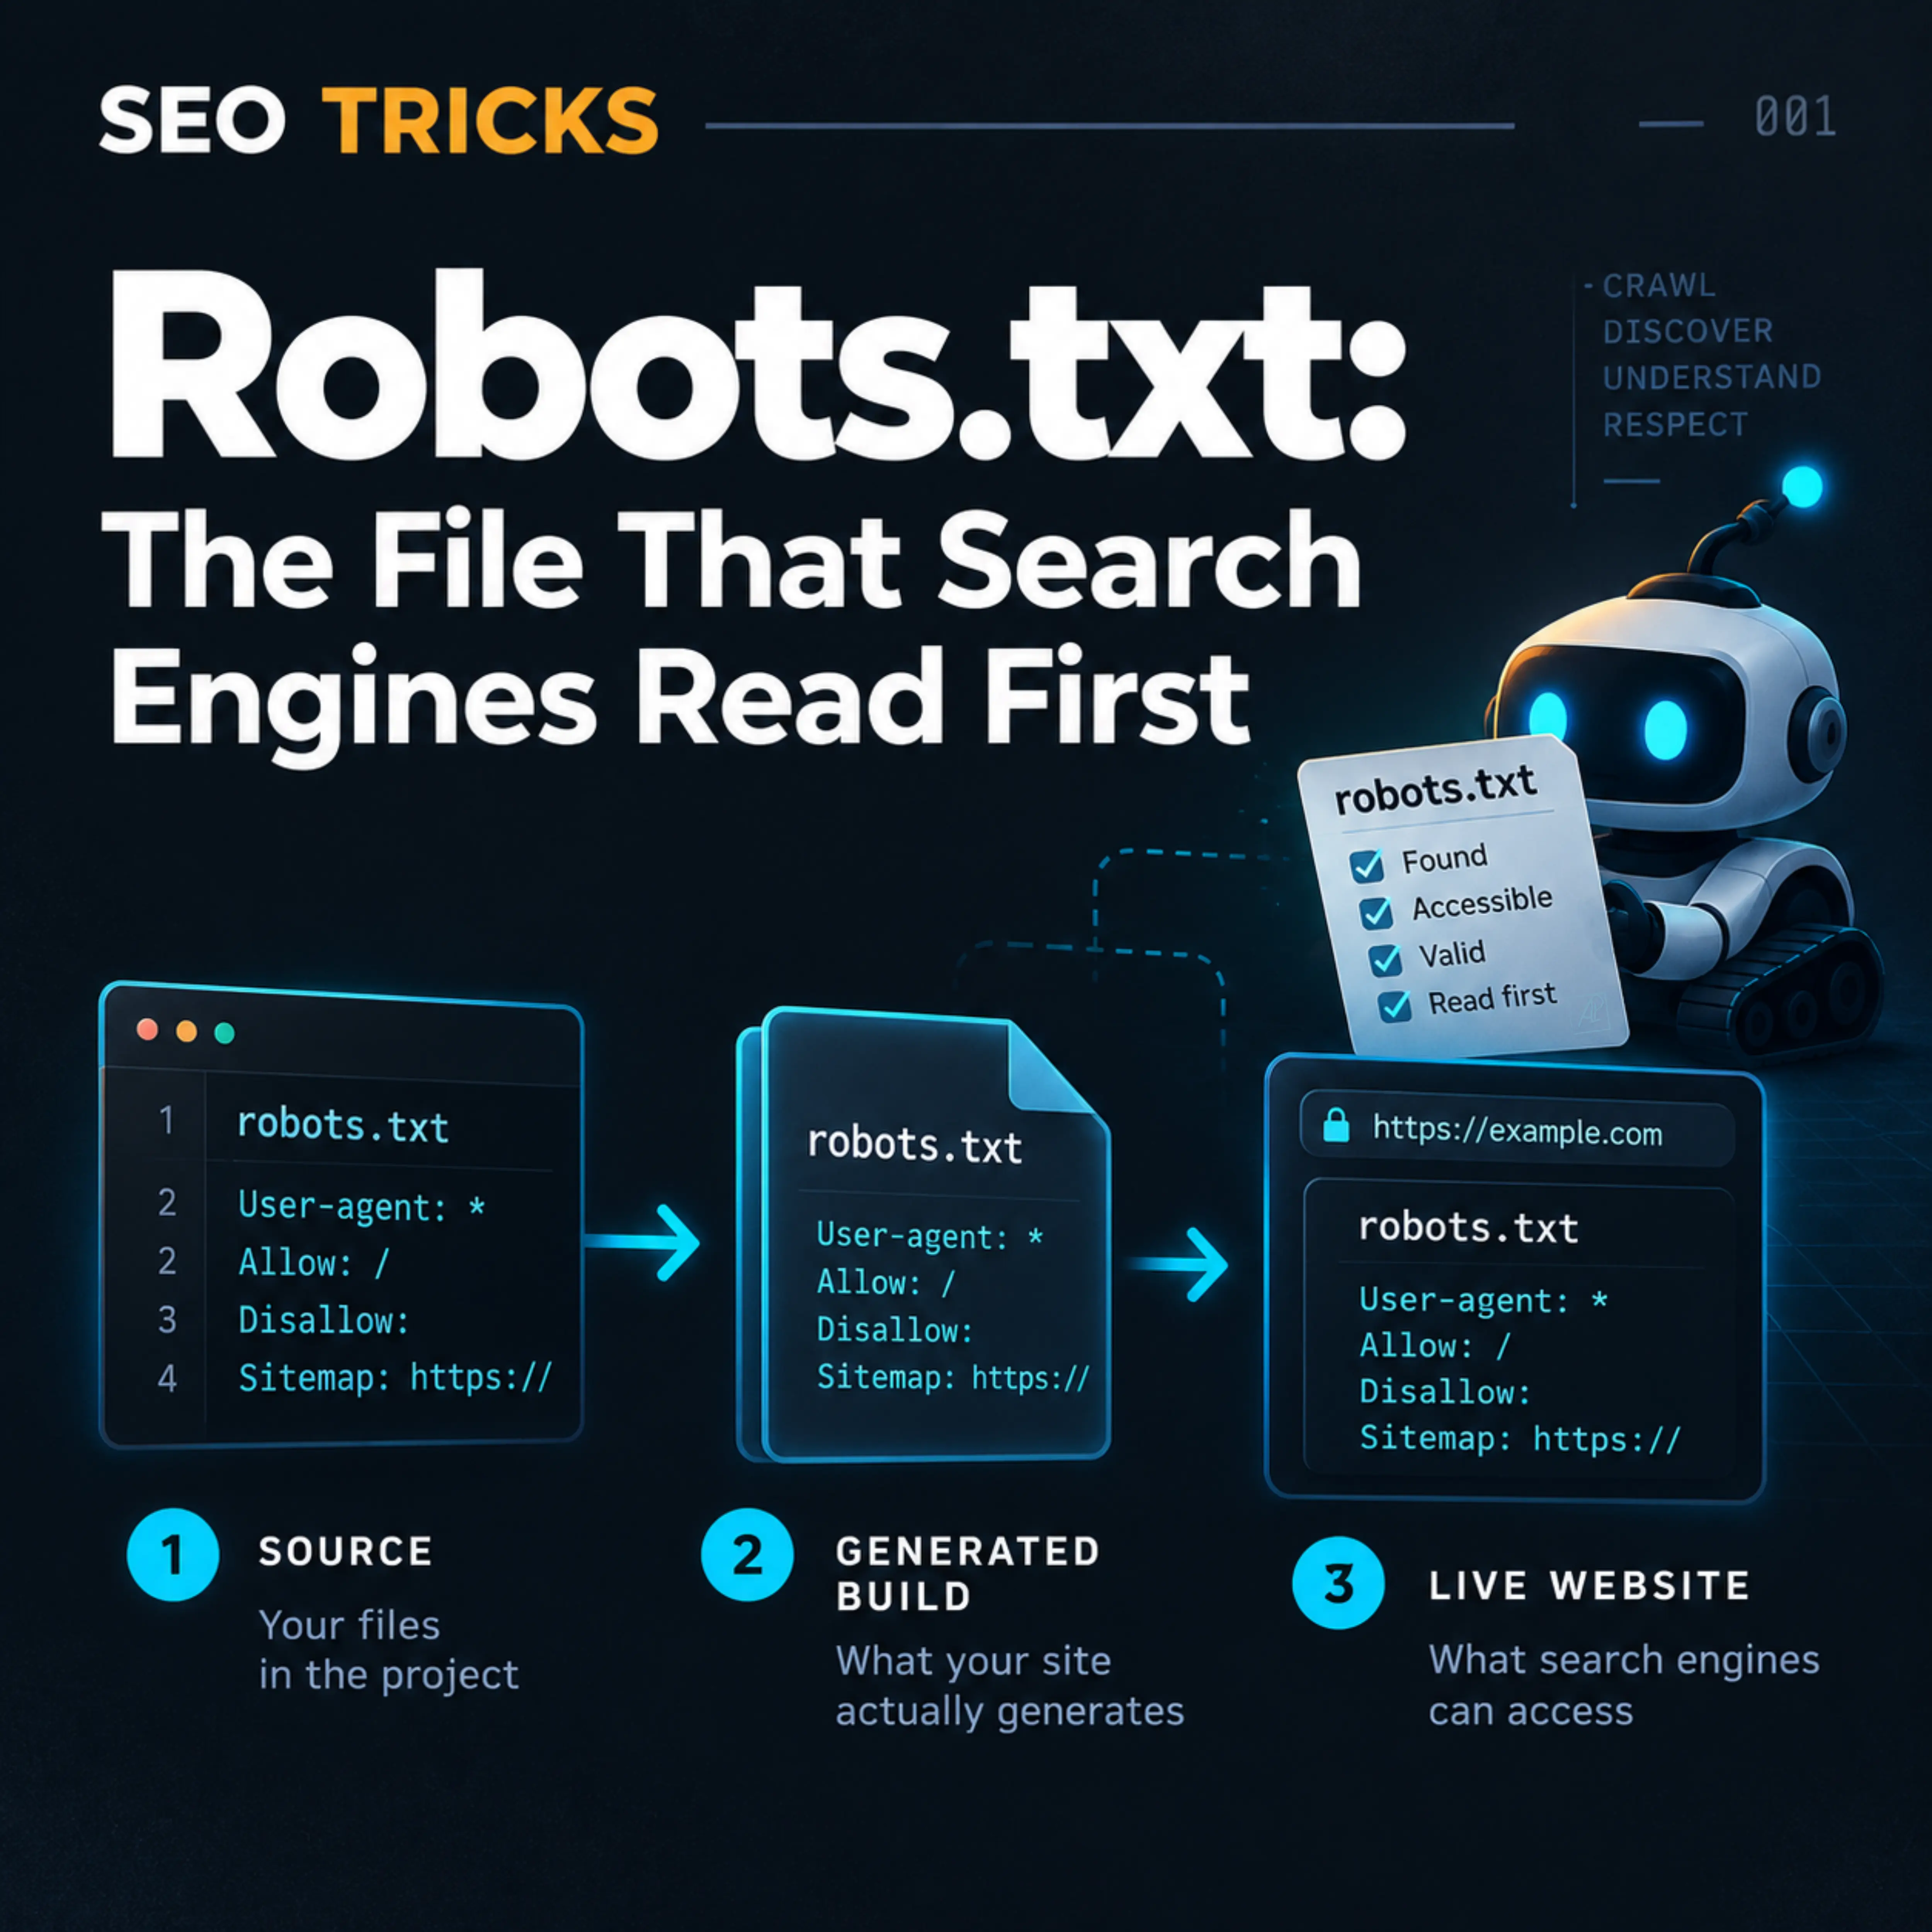
Robots.txt: O ficheiro que os motores de pesquisa leem primeiro | Truques de SEO
Antes de um motor de pesquisa explorar o seu site, há um pequeno ficheiro de texto à espera à porta.
Caixa de Resumo Rápido
O robots.txt é um simples ficheiro de texto que indica aos crawlers quais as partes de um site que podem ou não podem rastrear. É sobretudo uma diretiva de rastreamento, e não um comando de indexação ou de posicionamento.
Um
robots.txtválido deve estar disponível na raiz do site e devolver as instruções destinadas aos crawlers. Numa verificação SEO real, não basta saber que o ficheiro existe: é também necessário verificar se o seu conteúdo e a forma como é gerado estão corretos.
A Pergunta
Um ficheiro robots.txt parece simples demais para ser importante.
Um pequeno ficheiro de texto, num URL familiar:
https://example.com/robots.txt
Mas o que é que ele deve realmente fazer?
Diz aos motores de pesquisa quais as páginas que devem indexar?
Tem influência no posicionamento?
Ou limita-se a dar instruções aos crawlers antes de estes explorarem o site?
E, talvez mais importante:
O que devemos realmente esperar encontrar quando abrimos o robots.txt de um site?
É esta a pergunta que está na origem desta verificação SEO.
Porque é que isto é importante
Os motores de pesquisa precisam de rastrear os sites de forma eficiente. O ficheiro robots.txt disponibiliza, na raiz do site, um local padrão para publicar instruções de rastreamento.
Mas é fácil confundir vários conceitos de SEO.
Rastreamento não é o mesmo que indexação.
Indexação não é o mesmo que posicionamento.
Um ficheiro robots.txt diz respeito principalmente ao rastreamento: indica aos crawlers que áreas podem aceder e que áreas devem evitar.
Isso faz com que o ficheiro seja parte da infraestrutura técnica de SEO de um site. Se estiver em falta, inacessível, malformado ou contiver instruções não intencionais, os crawlers podem não receber as orientações que o proprietário do site pretendia fornecer.
E há uma outra lição importante:
Encontrar um ficheiro robots.txt não é o fim da verificação.
Também precisamos de analisar o que o ficheiro contém — e, num site gerado automaticamente, perceber como esse conteúdo foi parar ao ficheiro.
A Verificação
Começámos pela verificação mais simples:
O site tem sequer um ficheiro robots.txt?
O URL em produção deu-nos imediatamente a resposta:
https://pivtorak.studio/robots.txt → 404 File not found
Por isso, antes de verificarmos as diretivas, as regras de rastreamento ou a compatibilidade com o sitemap, precisávamos de perceber por que razão o ficheiro estava em falta.
Em seguida, seguimos o processo de construção do site e a forma como o Hugo poderia gerar o robots.txt.
Primeiro, verificámos a configuração do Hugo à procura da definição responsável pela geração do ficheiro:
enableRobotsTXT = trueDepois, procurámos um template robots.txt explícito no projeto e no tema:
layouts/robots.txt
themes/hugo-book/layouts/robots.txt
Verificámos também se já existia um ficheiro estático:
static/robots.txtNenhuma destas localizações continha um ficheiro-fonte robots.txt.
Em seguida, analisámos os templates de texto do tema Hugo e os formatos de output disponíveis, para perceber o que o Hugo poderia utilizar ao gerar um robots.txt como ficheiro de texto simples.
Por fim, em vez de fazer imediatamente o deploy de uma alteração ainda não verificada, executámos uma build local do Hugo e inspecionámos o resultado gerado:
E:\GitHubProjects\pivtorak.studio.github.io\public\robots.txtIsto deu-nos uma forma controlada de responder à pergunta seguinte:
O Hugo consegue gerar corretamente o ficheiro em falta antes de alterarmos o site em produção?
Verificação
Foi aqui que a nossa investigação mudou de rumo.
A build local confirmou que o Hugo conseguia gerar um ficheiro robots.txt — mas o ficheiro gerado não era um robots.txt correto para o nosso site.
Por isso, parámos antes de fazer commit ou deploy.
Source → Build
Na configuração de origem tínhamos:
enableRobotsTXT = trueDepois da build, o Hugo criou:
E:\GitHubProjects\pivtorak.studio.github.io\public\robots.txtÀ primeira vista, parecia que o problema estava resolvido.
Mas, quando abrimos o ficheiro gerado, encontrámos algo muito diferente do que esperávamos.
Em vez de um pequeno ficheiro de texto como:
User-agent: *
Allow: /

Sitemap: https://pivtorak.studio/sitemap.xml
o ficheiro gerado tinha aproximadamente 34 KB e começava assim:
Pivtorak.Studio
- ...
Depois, continuava com uma longa lista de páginas e URLs do site.
Era evidente que aquele conteúdo não correspondia a um conjunto de instruções para crawlers.
Na prática, o ficheiro era uma representação textual do conteúdo do site, e não um robots.txt funcional.
Porque é que isto era um problema
Um ficheiro robots.txt deve transmitir regras de rastreamento através de diretivas como User-agent, Allow, Disallow e, quando apropriado, uma referência Sitemap.
O nosso ficheiro gerado não fazia isso.
Por isso, embora:
o ficheiro existisse,
não podíamos concluir que:
o robots.txt funcionava.
Esta distinção era fundamental.
A build tinha criado corretamente um ficheiro no caminho esperado, mas o conteúdo desse ficheiro estava errado.
Assim, o resultado da verificação nesta fase era:
Source
   ↓
enableRobotsTXT = true
   ↓
Build
   ↓
robots.txt exists
   ↓
Content is incorrect
   ↓
STOP
Ainda não tínhamos chegado à etapa Live, e não havia razão para fazer commit ou deploy de um resultado que ainda não tinha sido verificado.
O passo seguinte, portanto, não era fazer o deploy.
Precisávamos de descobrir por que razão o Hugo tinha gerado exatamente aquele conteúdo e qual o template que o tinha produzido.
Conclusão
Uma verificação de robots.txt deve começar por uma pergunta simples:
O ficheiro existe e contém as instruções que deve conter?
Num site gerado automaticamente, a abordagem mais segura é verificá-lo em três níveis:
Source → Generated Build → Live
A origem mostra-nos o que pedimos ao sistema para fazer.
A build mostra-nos o que o sistema realmente gerou.
O site em produção mostra-nos o que os crawlers dos motores de pesquisa conseguem efetivamente receber.
O simples facto de um ficheiro aparecer na build não é suficiente. E o facto de existir no URL esperado também não é suficiente.
Verifique o ficheiro. Depois, verifique o que está dentro dele.
Por vezes, o ficheiro SEO mais pequeno merece uma verificação em três níveis.
robots.txt · SEO técnico · rastreamento · orçamento de rastreamento · sitemap
Alt-text:
Diagrama de verificação de robots.txt em três níveis, mostrando as verificações Source, Generated Build e Live website.
Truques de SEO. Robots.txt: O ficheiro que os motores de pesquisa leem primeiro. AP | Pivtorak.Studio. 07.09.2026
© Anna Pivtorak (Kostyuk)